A Survey of Embodied Learning for Object-Centric Robotic Manipulation
Intro
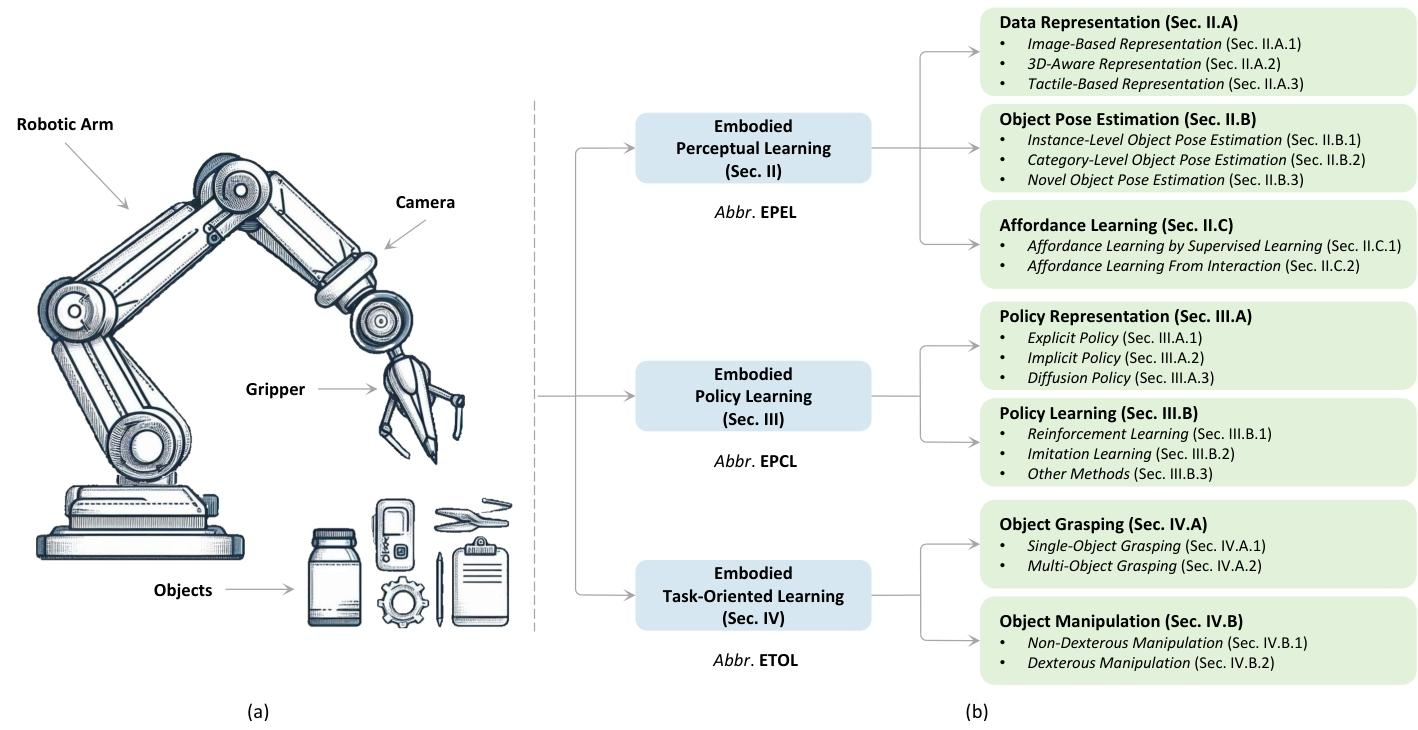
综述文章 划分现有工作为三个分支
- Embodied perceptual learning
- Embodied policy learning
- Embodied task-oriented learning
本综述主要聚焦 Embodied task-oriented learning 这一任务
七个子方向
- data representation
- object pose estimation
- affordance learning:指学习物体可供交互、执行动作的属性
- policy representation
- policy learning
- object grasping
- object manipulation
Embodied Perceptual Learning
A. Data Representation
三种数据表征方法
- Image-Based
- 3D-aware
- tactile-based
1. Image-Based Representation
利用 RGB 图像
又分四类
- SISB
- SIMB
- MISB
- MIMB
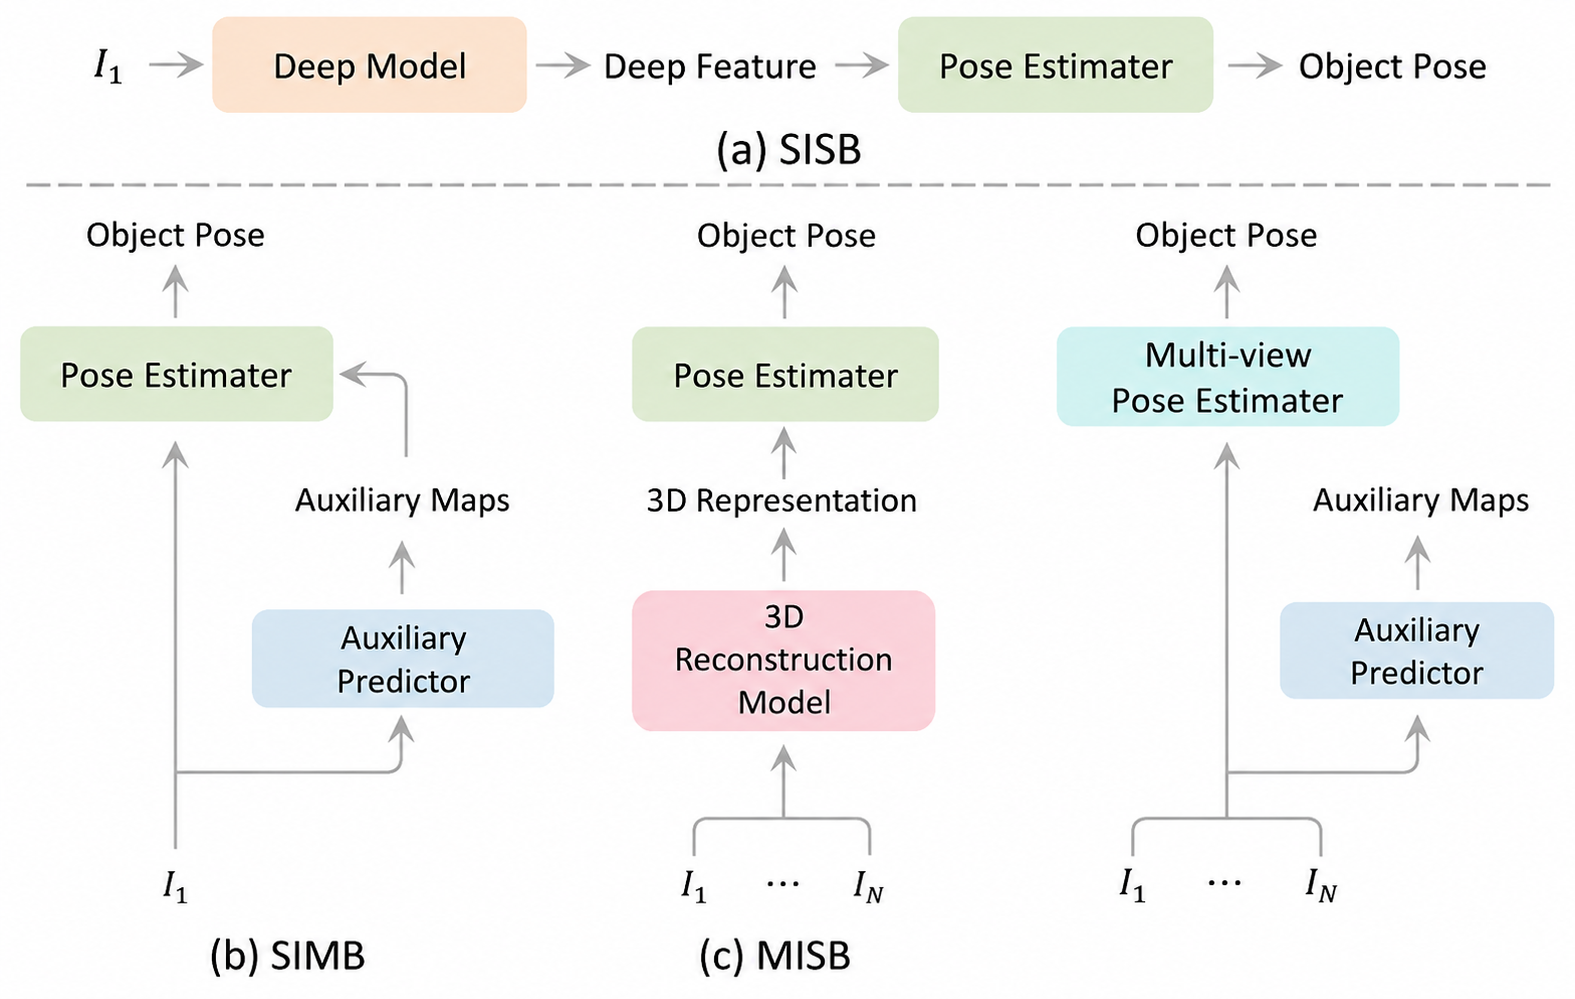
SISB 速度快 结构简单 三维能力局限 位姿估计粗糙
SIMB 新增功能分支 提取更丰富的辅助信息 单张图像做预测本身存在固有局限
MISB 多张图像来克服 开展三维重建 可通过 神经辐射场 或 高斯溅射 等前沿技术实现
MIMB 直接从多位置采集图像生产多视图表征 跳过重建阶段 增设额外预测器以获取补充信息,弥补三维信息的缺失
2. 3D-Aware Representation
RGB‑D 图像作为输入
基于生成表征形式不同 分为
- depth-based representation (DR)
- point cloud-based representation (PR)
- transition- based representation (TR)
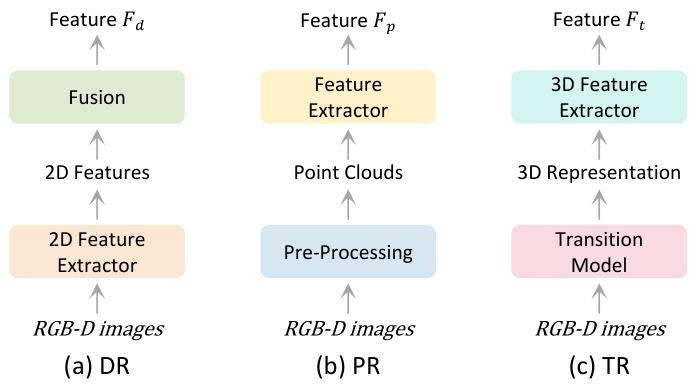
DR:
-
提取特征直接用 后期修正
如 Lenz
- 快速过一遍图像特征,把一大批明显抓不住的候选点直接删掉,剩下少量有可能成功的抓取位置
- 仔细评估剩下的候选,选出最好的抓取点
-
two‑stream network
把彩色图 (RGB)、深度图 (D) 分开走两条独立的神经网络通道 特征融合
PR:
先经过预处理生成点云
以往处理由 RGB‑D 图像转换得到的点云的方法,通常会对点云进行体素化,并利用三维卷积神经网络提取特征
体素化:点云嵌入3D中像素格子 内存开销巨大
PointNet-like 专为点云设计 该框架能够直接从点云中的各个单点提取特征
3. Tactile-Based Representation
该类信息对于提升机器人执行复杂任务的能力、提高其操作精度与环境适应性至关重要
代表性设备:Gelsight DIGIT AllSight
采集:接触位置、法向力、切向力与扭矩等
一种常见representation 指定时间窗口内对触觉反馈进行多次采样而得到的时间序列 可以用 LSTM 转换为特征向量 简化后续模型处理
另一种representation可视化触觉信息
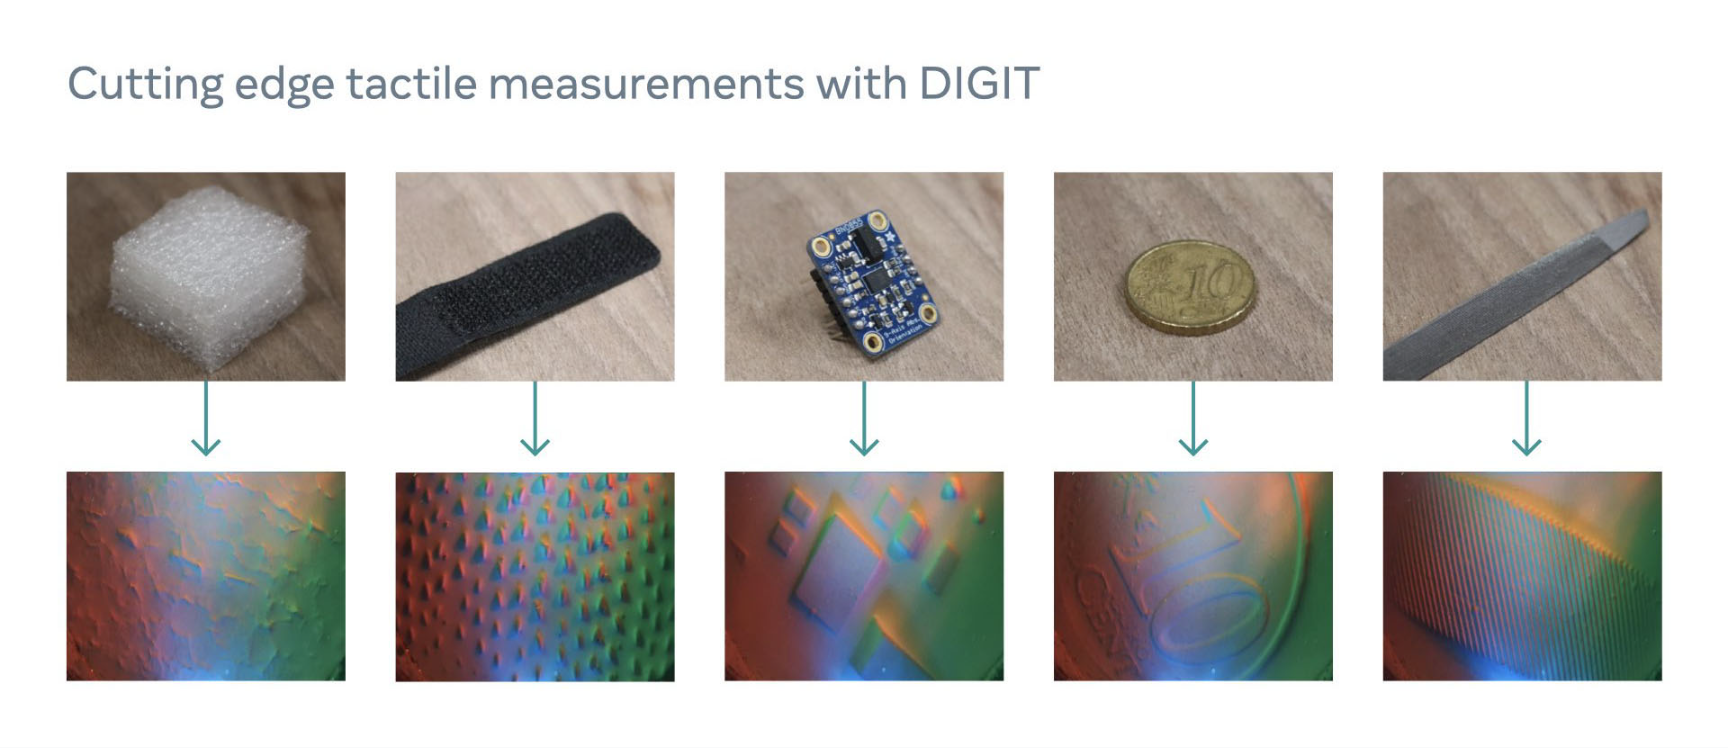
生成高质量的触觉表征通常需要大量训练数据。然而,采集触觉数据比视觉数据更加耗时
为克服这一难题,研究人员提出利用 NeRF、GAN 等技术生成触觉数据
summary
-
基于图像的表征降低了对传感器的要求,但受限于仅依靠 RGB 图像信息。
-
具备三维感知能力的表征同时利用图像与深度数据,可为学习任务提供鲁棒性更强的表征。
-
基于触觉的表征作为一种补充手段,能够进一步提升机器人的感知能力。
-
未来的研究应重点探索多种表征方式的融合,充分发挥各自的优势。
B. Object Pose Estimation
物体位姿估计方法主要分为两类
-
2D 平面估计
-
3D 下 6维度位姿估计 [ x y z + 三个角度 ] 下分三类
- instance‑level
- category‑level
- novel object pose estimation
instance‑level
为图像, 为 物体 对应的3D 模型集合,
一部分方法利用深度神经网络直接回归物体的 6D 位姿,代表工作包括 PoseCNN 、CDPN。但这类基础方法通常还需要后续优化处理
另一类方法先借助关键点学习 2D‑3D 或者 3D‑3D 对应关系 之后采用基于随机抽样一致(RANSAC)的 PnP(透视 n 点)算法
Details
PnP 求解方程:
- :2D 像素坐标
- :3D 点坐标
- :相机内参矩阵(已知)
- :要求的位姿(未知)
RANSAC
重复很多次(比如100次):
- 从所有点中随机抽4个点
- 用这4个点跑PnP,得到一个候选位姿
- 用这个候选位姿,把所有3D点投影到2D
- 数一下:有多少个点的投影位置和真实2D位置很接近(误差小于阈值) -> 这些点就是「内点」
- 记录这次得到的内点数量
最后:选内点最多的那次结果,作为最终位姿
模板匹配、特征点投票 也是十分有潜力的 6D 位姿估计方案。
精度很高 不适合大规模
category‑level
NOCS: 一种面向物体类别的坐标系。NOCS 将物体的位姿与尺寸编码为归一化坐标向量,随后借助神经网络可以直接推理出观测图像像素与 NOCS 坐标之间的对应关系
难以有效泛化至关节物体 因而提出
ANCSH(面向关节感知的归一化坐标空间层级结构),这是一种专为关节物体设计的类别级表征方法
CAPER(CAPE‑Real)的真实场景任务基准
novel object pose estimation
传统方案一般采用 图像匹配 或者 特征匹配 技术
近年来越来越多的研究开始利用大模型提升深度模型在 NOPE 任务上的泛化性能
C. Affordance Learning
得到物体的估计位姿之后,下一步便是识别物体上可供交互的潜在区域 即 Affordance Learning
分为
- affor-dance learning by supervised learning
- affordance learning from interaction
1. Affordance Learning by Supervised Learning
目前已经诞生了多种利用静态数据学习可供性的方法
AffordanceNet 过人工标注的 RGB 图像作为输入,通过两条相互独立的分支同时完成物体定位与可供性预测
AffordanceNet
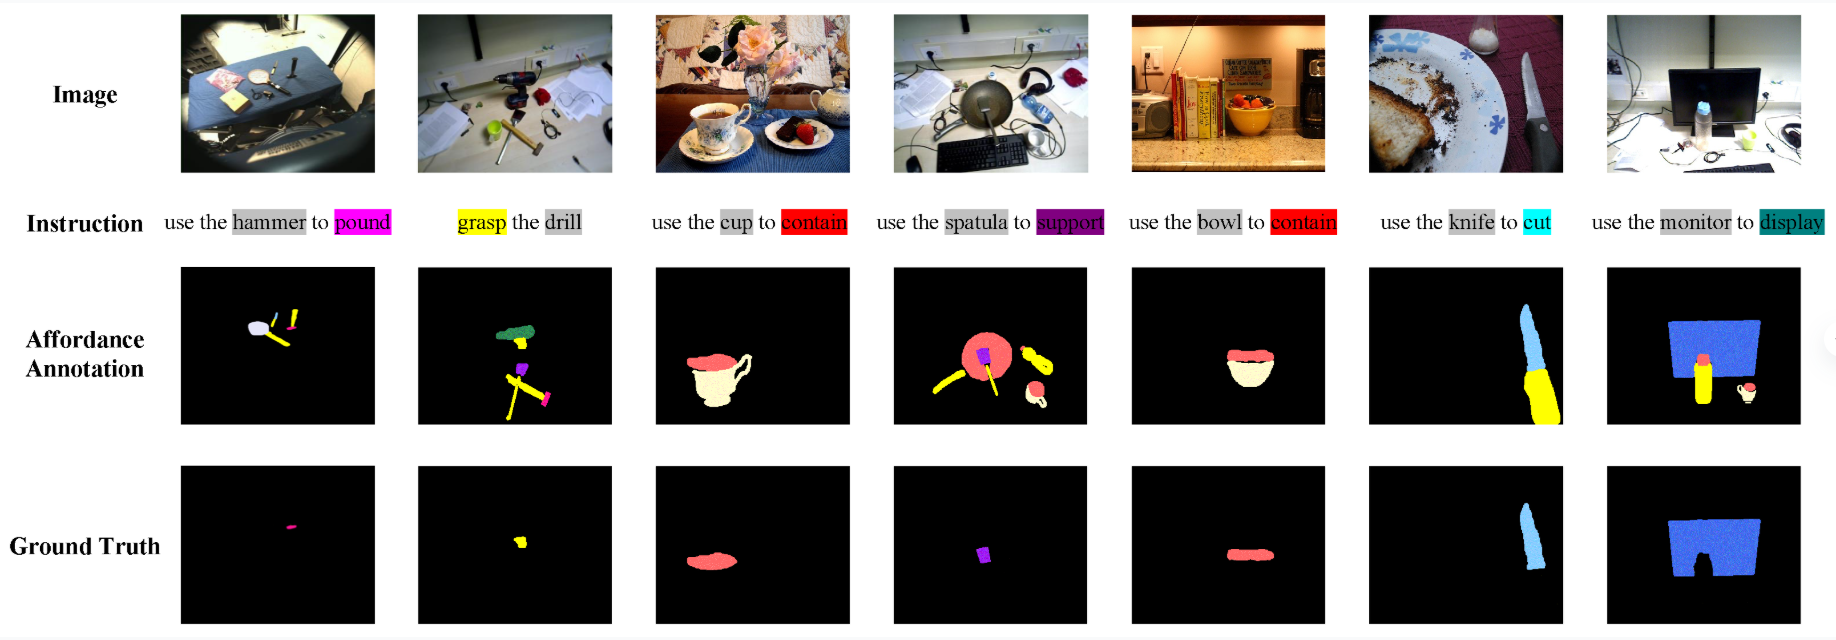
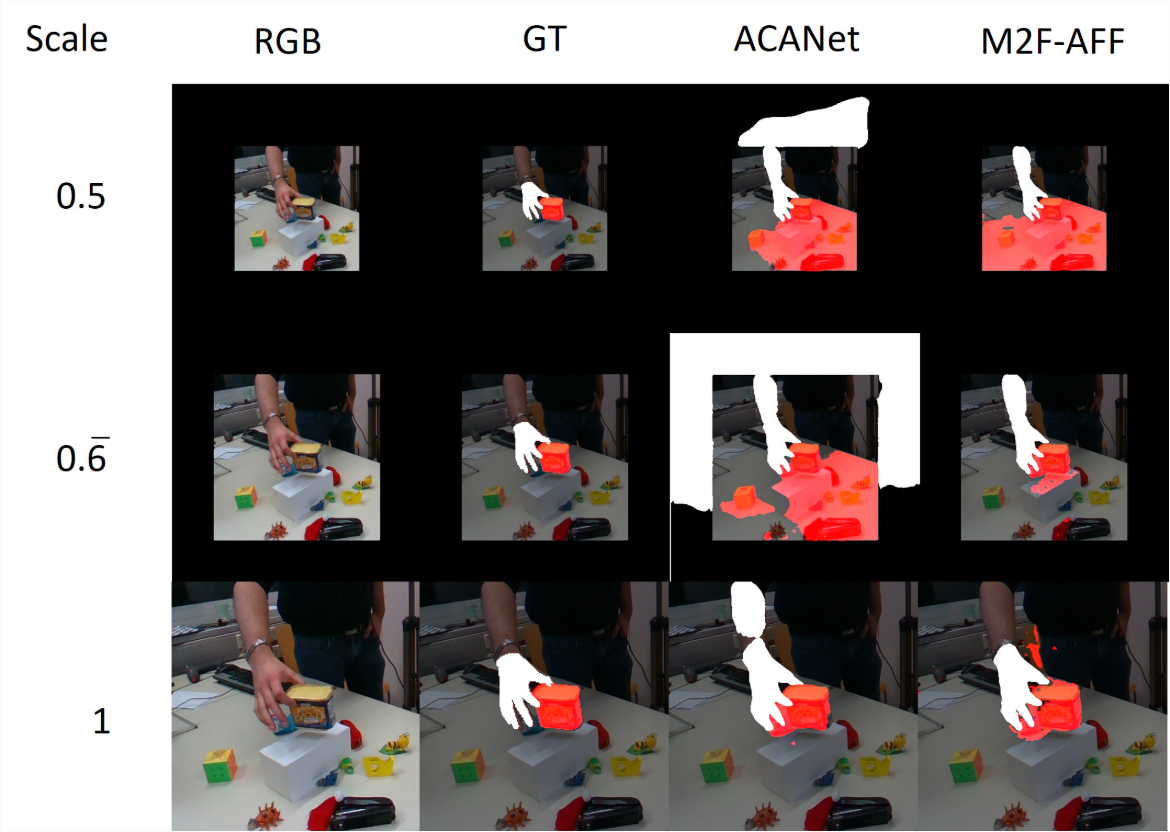
Nagarajan 采用交互热点图来表示物体可供性
Grounded Human-Object Interaction Hotspots From Video
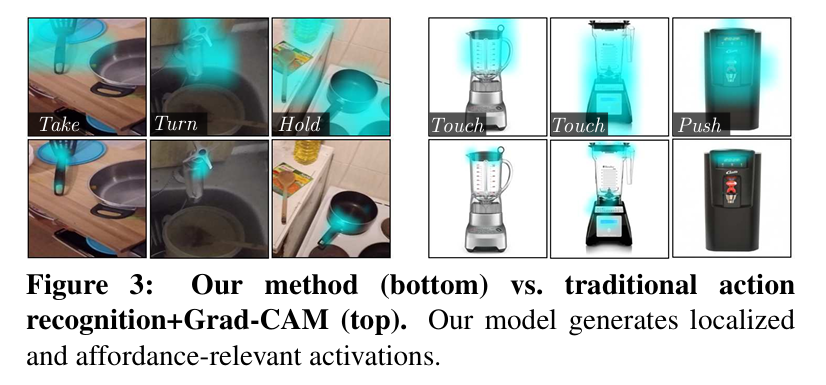
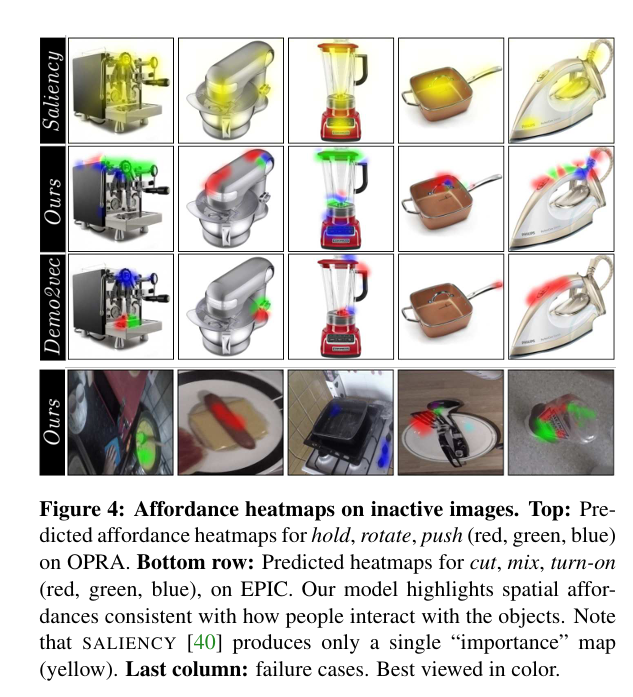
尽管上述方法在静态数据集上取得了不错的效果,但并未探究将学习得到的可供性应用于机器人操作任务
VRB 引入轨迹预测模型,从第一人称视角视频中提取可供性,并将训练所得模型集成至多种机器人学习框架
Robo‑ABC 建一个记忆库,遇到新物体时,从库里检索最相似的已知物体,然后用 扩散模型的语义对应能力 把接触点从已知物体迁移到新物体上
RAM 提出了一种基于检索的架构,将二维可供性信息升维至三维,实现了与机器人本体形态无关的机器人操作。该框架采用分层检索流程,将可操作知识从域外数据迁移至特定目标域
OpenAD 用 CLIP 的 文本-图像 对齐能力,实现开放词汇
2. Affordance Learning From Interaction
基于交互的可供性学习框架旨在通过仿真环境采集训练数据
该方法使智能体能够从交互过程中完成学习,为其落地到真实世界部署积累关键的先验知识
Discusion
- 当前基于监督学习的可供性学习方法受限于其针对特定领域数据或特定任务的约束
- 而基于交互的方法则面临样本效率低下的问题
- 设计高效框架 挖掘物联网海量数据 快速适配各种能力
EMBODIED POLICY LEARNING
具身策略学习的过程划分为两个基础阶段
- 策略表征 策略长什么样、用什么形式来表达
- 策略学习 怎么把这个策略训练出来
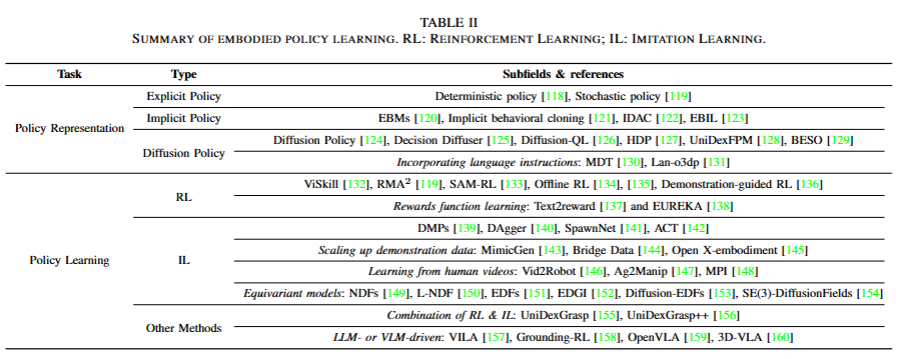
A. 策略表征
依据建模方案的不同,无论动作空间属于离散空间还是连续空间,策略表征均可分为显式策略、隐式策略、扩散策略三类
Explicit Policy
- 确定性策略:输出动作
- 随机性策略:输出分布 采样动作
在离散动作空间中,策略表征可转化为从有限动作集合里选取最优动作的过程。用分类分布
在连续动作空间内,通常选择对角高斯分布表征动作分布,并以均方误差(MSE)等回归损失函数或是强化学习目标作为优化导向,策略会同时输出均值 和标准差 ,然后从得到的分布中采样动作,采样公式如下:
通常认为网络输出 防止标准差为负数
Implicit Policy
隐式策略借助基于能量的模型 为每一个动作分配一个评价值
通过优化一个连续函数,求解能量最小的动作
给定一组专家示教样本或是在线采集得到的轨迹 ,隐式策略采用 InfoNCE 风格损失函数进行训练。训练完成后,会采用随机优化方法完成隐式推理,求解最优动作
算法细节
对每一条专家样本 ,构造负样本,随机采样一堆别的动作
在同一个画面下,专家动作能量要显著低于所有乱采样出来的负动作能量:
反向传播更新网络参数
推理阶段
- 初始化一批候选动作:随机生成几十上百个机械臂候选动作。
- 迭代优化(循环 N 次)
- 把当前观测 + 每一个候选动作,送入训练好的能量网络,算出每个动作的能量分数。
- 根据能量分数,沿着降低能量的方向,调整修改这些候选动作;同时加入少量随机噪声(随机优化的来源)。
- 迭代结束后,从这批候选动作中挑能量最小的那一个
EBIL(Energy‑Based Imitation Learning):EBM 结合逆强化学习
逆强化学习:普通强化学习需要人为写奖励函数(做得好给高分);逆强化学习不给奖励,从专家示范数据反推出奖励好坏。
计算开销更大,速度慢;但是擅长处理多模态动作。
Diffusion Policy
B. 策略学习
下一个任务是是训练策略
分为
- 强化学习
- 模仿学习
- 以及融合前两者技术要素或采用全新学习范式的其他方法
1. 强化学习
将策略学习过程建模为马尔可夫决策过程(MDP)
优化目标可写为:
PPO
PPO 大致介绍
就是在重要性采样基础上
变成:
再去求梯度
ViSkill 提出了一种名为 value-informed skill chaining 的全新机制,用以学习平滑的子任务策略
RMA
SAM-RL
奖励函数的设计仍然是强化学习领域的一大难题,因为要精准刻画任务目标,往往需要领域专属知识
近年来,越来越多的研究开始挖掘大语言模型(LLM)在奖励学习方面的能力
Text2reward 与 EUREKA 利用大语言模型的理解与生成能力,将用自然语言描述的任务目标转化为稠密且可解释的奖励代码,还可以结合人类反馈对奖励代码进行迭代优化
2. 模仿学习
复刻专家行为
- 行为克隆 BC
- 逆强化学习 IRL
- 生成对抗模仿学习 Generative Adversarial Imitation Learning (GAIL)
行为克隆是一种简单却十分有效的方法,该方法采用监督学习,最小化专家动作与策略预测输出动作之间的均方误差,以此完成策略学习。
逆强化学习执行两阶段循环流程:首先从专家演示数据中推导出奖励函数,之后再借助强化学习技术完成策略优化。
生成对抗模仿学习是基于生成模型的方法,依靠对抗学习同步训练判别器和动作生成器,以此区分专家真实动作和策略所生成的动作。
由于采集人类专家演示样本的成本很高,研究重点转向演示数据规模扩充。
此外,部分研究者挖掘野外公开数据在模仿学习中的应用潜力,充分利用海量第一人称人类活动视频资源
等变模型类
SE (3) = 三维刚体变换(3D 旋转 + 3D 平移)
Equivariant models 等变模型:物体做旋转 / 平移,模型输出也跟着做一模一样的旋转平移;数学
神经描述子场 NDF(Neural Descriptor Fields):给物体三维空间每一个 3D 点,算一个特征向量 SE (3)‑等变的隐式 3D 物体表征
等变描述子场 EDF: EDF = SE (3)‑等变 + 能量模型 EBM + 端到端可训练
后续衍生:Diffusion‑EDFs / EDGI / SE (3)‑DiffusionFields:把扩散模型和 EDF 等变能量模型结合
3. 其他方法类
融合强化学习与模仿学习
UniDexGrasp 和 UniDexGrasp 延续了师生学习范式 采用无模型强化学习算法训练教师模型 教师模型的输入为真值状态(环境完整、精确、底层的全部真实信息) 将教师模型习得的技能通过模仿学习蒸馏到学生策略当中;学生策略仅能获取真实观测信息,例如相机采集得到的视觉图像
LLM 与 VLM :这类模型接收当前视觉观测与语言指令作为输入,借助可训练适配器生成对应的动作序列
4. Discussion
在样本效率、域自适应以及泛化能力方面仍然存在诸多挑战
需要充分挖掘大语言模型与视觉‑语言模型的潜力
EMBODIED TASK-ORIENTED LEARNING
现有的面向任务的具身学习研究主要围绕两大方向展开:物体抓取与物体操作
A. 物体抓取
分为
- 单物体抓取
- 多物体抓取
1. 单物体抓取
分三阶段
- 抓取检测
- 轨迹规划
- 动作执行
部分方法以开环方式执行:选定好了抓取点以后,机械臂一路按预先规划好的路线抓过去,抓取途中不再用摄像头、触觉传感器实时看情况、修正动作
开环容易失败
闭环方式:依靠实时反馈修正感知误差、应对物体受到的扰动
物体跟踪与视觉伺服是实现闭环抓取的两类主流方法
- 物体跟踪:实时测出目标物体当前的 6D 位置和角度
- 视觉伺服:更进一步(?)直接拿图像像素信息实时控制机械臂每一步运动
还有三项难度较高的特殊任务因其挑战性而受到广泛关注:透明物体抓取、稠密杂乱环境下的抓取以及动态物体抓取
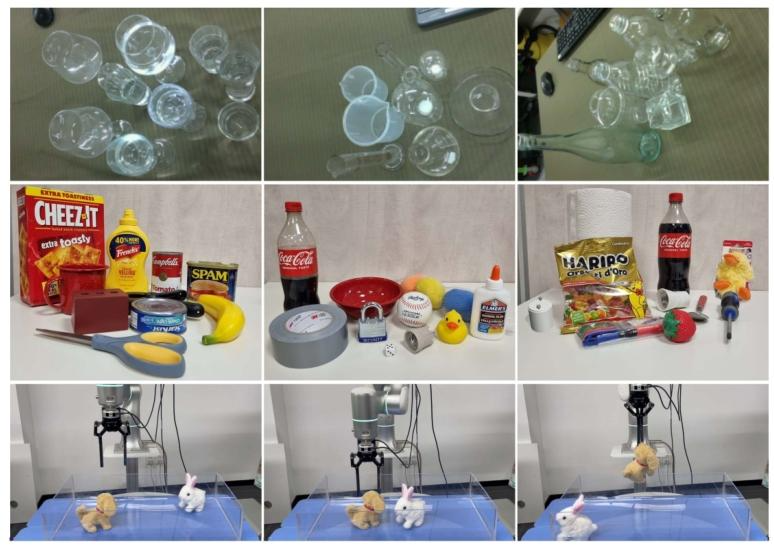
透明物体抓取
透明物体指光线可以穿透,且不会发生明显散射或反射的物体,例如玻璃容器、塑料制品
挑战
- 缺少纹理,外观特征 难以采集表面信息 识别定位
- 摩擦力可能低
大多数抓取方法高度依赖深度图像:DFNet,这是一款端到端深度补全网络,利用 RGB 图像以及精度欠佳的深度图生成优化后的精细深度图
有一些方法借助神经辐射场(NeRF)直接生成透明物体的深度信息
其他可用信息
- TRansPose:融合立体 RGBD、热红外图像以及物体位姿信息
- TGF‑Net:学习表面片段、边缘特征与几何特征
杂乱环境抓取
挑战
- 难以识别定位
- 防止碰撞 保证安全
当前相关研究主要聚焦于无碰撞物体抓取
提出**可抓取度(graspness)**这一概念,该指标融合几何特征与碰撞标签,用来评估杂乱场景中物体可供抓取的区域
还有一部分研究不再局限于无碰撞抓取,开始探索抓取‑推送协同策略,通过推送动作改变周边物体的位置
运动物体抓取
挑战
- 实时性
- 非线性、不可预测的运动轨迹
现有方向
-
人‑机器人(H2R)物体交接,该方向旨在让机器人能够接收人类递过来的物体。已有部分研究通过识别人类意图来提升人‑机交接任务的成功率
-
无人工参与的运动物体抓取
2. 多物体抓取
单次操作周期内高效抓取两个及以上物体的高阶性能
在物流自动化、产品包装、家庭服务等众多机器人应用场景中具备巨大潜力
挑战
- 高精度感知
- 复杂策略制定
- 精准的执行协同
整体抓取问题
-
部分方法将其视作一种整体抓取问题 旨在通过夹爪或多指结构,单次动作包裹住全部物体 在实际操作过程中,接触点只能落在所有物体组成的整体外轮廓
-
Sun 等 提出了一套完整的分类体系,划分出 12 种不同类型的多物体抓取方式
-
在算法中引入物体间摩擦力
-
借助推送动作,将无序摆放的多边形物体组有序聚拢成紧凑、便于抓取的物体簇
视作独立单元
Discussion
- 单物体抓取(SOG)由于问题难度相对较低,相关研究已经十分广泛并取得丰硕成果,正逐步走向实际落地应用
- 物体抓取(MOG)因其较高的复杂度,发展速度较为缓慢
B. 物体操作
概念上任务划分
- 非灵巧操作
- 灵巧操作
1. Non-Dexterous Manipulation (NDM)
采用夹爪、吸盘、推具等简易末端执行器开展作业
拾取‑放置是非灵巧操作(NDM)中的一项基础任务 早期依靠脚本化规划与运动控制完成作业 近期开始面向未知物体构建通用拾取‑放置策略
部分研究在基础拾取‑放置能力之上进行拓展,实现物体重排列、套件装配 等更高阶任务
另一类研究方向侧重于提升机器人的智能水平 使其能够处理更为复杂的任务
例如操作可变形物体与铰接物体
该领域的研究者借鉴日常生活中人‑物交互的经验,针对衣物 绳索 流体 等物体研发专用的操作策略
而铰接物体操作的核心难点在于:精确感知并控制每一个关节部件的角度与位置,同时还需要充分掌握物体的运动学特性与动态交互规律。门、抽屉、水桶等典型铰接物体是当下的主要研究对象。
2. Dexterous Manipulation (DM)
复刻人类精细动作,例如拧开瓶盖、操控工具等。该技术依赖高性能机械手
早期:轨迹优化 运动‑动力学规划 高度依赖精准的物体动力学参数,同时需要对物体几何形状做出简化假设
近年来,基于模型 与 无模型 的强化学习方法在灵巧操作领域得到越来越广泛的应用
Tool Manipulation
其应用范围覆盖工业自动化、外科手术乃至太空探索,让机器人可以完成复杂度高、专业性强的作业任务
其学习范式与普通物体操作较为相似,但更加注重将工具融入机器人的动作闭环
3. Discussion
非灵巧操作(NDM)与灵巧操作(DM)均包含多样且复杂的任务。现有方法大多针对若干特定任务设计,距离实现真正通用化的物体操纵能力仍存在较大差距
Dataset And Evaluation Metrics
A. Datasets
下表汇总综述中面向物体抓取与物体操作的代表性数据集。#Categories 为物体类别数,#Objects 为物体实例数;sim 与 real 分别表示仿真和真实数据。
| Task | Dataset | #Categories | #Objects | Domain | Size | Modality |
|---|---|---|---|---|---|---|
| Object Grasping | Cornell | - | 240 | real | 885 images, 8,019 grasps | RGB-D |
| Object Grasping | Multi-Object | - | ~400 | real | 96 images, 2,904 grasps | RGB-D |
| Object Grasping | Jacquard | - | 11K | sim | 54K images, 1.1M grasps | RGB-D |
| Object Grasping | VR-Grasping-101 | 7 | 101 | sim | 150K grasping demonstrations | RGB-D |
| Object Grasping | ACRONYM | 262 | 8,873 | sim | 17.7M parallel-jaw grasps | PointCloud |
| Object Grasping | EGAD | - | 2,331 | sim | 233K antipodal grasps | PointCloud |
| Object Grasping | GraspNet-1Billion | - | 88 | real | 97,280 images, ~1.2B grasps | RGB-D |
| Object Grasping | Grasp-Anything | 236 | ~3M | sim | ~1M samples, ~600M grasps | Text/Image |
| Object Manipulation | YCB | 5 | 77 | real | 600 RGB-D images for each object | RGB-D |
| Object Manipulation | AKB-48 | 48 | 2,037 | real | 100K generated RGB-D images | RGB-D |
| Object Manipulation | PartNet-Mobility | 46 | 2,346 | sim | 14,068 articulated parts | PointCloud/RGB-D |
| Object Manipulation | GAPartNet | 27 | 1,166 | sim | 8,489 part instances | PointCloud/RGB-D |
| Object Manipulation | ManiSkill2 | 20 | 2,000+ | sim | 4M demonstration frames | PointCloud/RGB-D |
| Object Manipulation | ARNOLD | 8 | 1,078 | sim | 10,080 demonstrations | Text/RGB-D |
| Object Manipulation | Bi-DexHands | 20 | - | sim | 1,638,400 step demonstrations | Force/PointCloud/RGB-D |
| Object Manipulation | DexArt | 4 | 82 | sim | 6K point clouds for each object | PointCloud |
| Object Manipulation | PartManip | 6 | 494 | sim | 11 object categories, 1,432 tasks | PointCloud |
| Object Manipulation | BEHAVIOR-1K | 1,000 | 9,318 | sim | 50 scenes, 1,949 object categories | RGB-D |
B. 指标
1. 物体抓取
点指标 + 矩形框指标
点指标
预测抓取框的中心点与真实抓取点之间的距离小于给定阈值,则判定本次预测正确
但该指标并未考虑抓取姿态角度,有可能高估算法的实际性能
此外,抓取成功率(GSR)是真实机器人实验中最常使用的评价指标
矩形框指标
专门针对抓取矩形框设计,将角度误差纳入评判标准。该指标首先筛除与真实抓取框 G 角度偏差超过 30° 的预测框;再对剩余预测框,计算预测抓取框 和真实框 G 之间的交并比(IoU)
例子
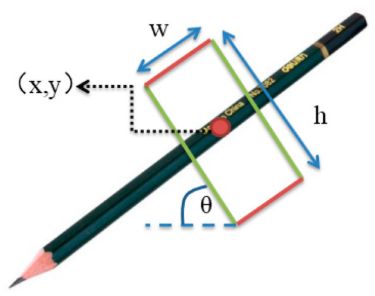
这个矩形通常用五个参数表示:(g=(x,y,\theta,w,h))
| 参数 | 对应的意思 |
|---|---|
| (x,y):框的中心 | 夹爪对准哪里,也就是抓取中心 |
| (\theta):框的角度 | 夹爪在图像平面内转多少角度 |
| (w):两指之间的距离 | 夹爪的张开宽度 |
| (h):另一个边长 | 夹指在图像平面内的尺寸或所表示的抓取区域长度 |
2. 物体操纵
任务成功率 TSR
单任务重复执行 不同操纵任务对应的成功判定条件并不相同 可以从多角度评估模型性能,例如仿真时长、物体运动学扰动程度
Application
下表汇总以物体为中心的具身学习在不同机器人领域中的典型应用。
| Area | Example | Short Description |
|---|---|---|
| Industrial Robots | Assembly line operations | Performing tasks such as parts installation and circuit board welding. |
| Industrial Robots | Packaging and sorting operations | Providing fast and accurate packaging and sorting services for industries like retail and food. |
| Industrial Robots | Maintenance operations | Performing equipment maintenance tasks in hazardous environments. |
| Agricultural Robots | FarmBot | Accomplishing intelligent planting through monitoring plant growth, fertilization, and cultivation control. |
| Agricultural Robots | FAR | Identifying fruits and their ripeness, and performing tasks such as pruning. |
| Agricultural Robots | Rowbot | Designed for crops like corn; capable of fertilizing, seeding, and weed removal. |
| Domestic Robots | Household assistants | Helping with tasks like organizing desks, performing cleaning duties, and folding clothes. |
| Domestic Robots | Smart caregiving | Offering daily care and health monitoring for people in need of special care. |
| Domestic Robots | Cooking | Automatically completing specific cooking tasks, such as frying eggs, stir-frying, and toasting bread. |
| Surgical Robots | Cutting and suturing | Utilizing specialized surgical tools to perform precise cutting and suturing. |
| Surgical Robots | Automated control | Performing intelligent adjustment of the speed and direction of surgical instruments. |
| Surgical Robots | Surgical collaboration | Collaborating in real time with doctors during surgery, providing real-time process monitoring and data-driven decision support. |
| Other Applications | — | Space exploration, education, research. |
Challenge and Future
A. Sim-Real
感知鸿沟、控制器精度误差、仿真偏差
| 方法 | 核心思路 | 干了什么 |
|---|---|---|
| 域随机化 | 多样化仿真环境 | 训练时随机修改光照、摩擦、颜色等因素,提高策略鲁棒性。 |
| 物理约束正则化 | 约束动作符合物理定律 | 在损失函数中加入惩罚项,避免输出物理上不可能的轨迹。 |
| 迭代自训练 | 仿真与真机双向循环迭代 | 用真机运行产生的新数据反向迭代,持续优化策略。 |
B. Multimodal Embodied LLMs
将 affordance 与 物理概念 融入大语言模型
C. Human-Robot Collaboration
D. Model Compression and Robot Acceleration
在嵌入式系统、移动设备、边缘计算等落地场景
E. Model Interpretability and Application Safety
引入对抗训练,提升机器人抵御攻击的能力
搭建鲁棒的安全监控方案,及时识别潜在的安全风险