Physically Ground Commonsense Knowledge for Articulated Object Manipulation with Analytic Concepts
如何将多模态大模型输出的语义层面知识有效映射到物理世界,以此充分指导机器人完成通用铰接物体操作,仍是一个尚未得到充分解决的难题
提出 analytic concepts
基于数学符号程序化定义 连接多模态大语言模型推理得到的语义知识与真实机器人所处的物理世界
Analytic Concept
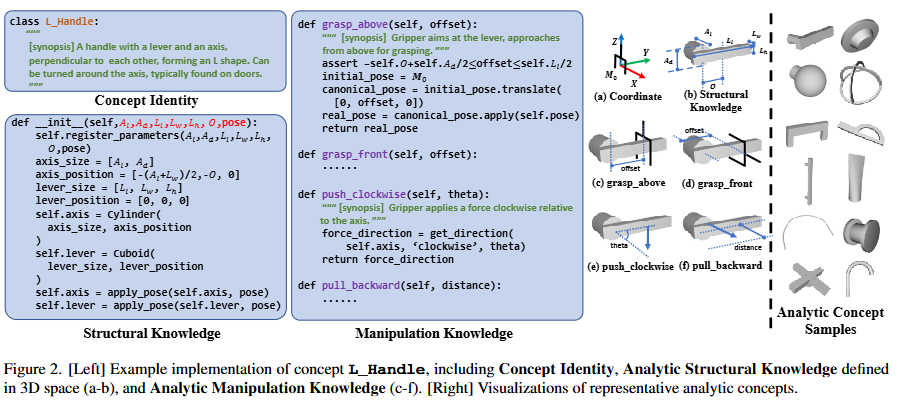
analytic concept 由三部分组成:
Method
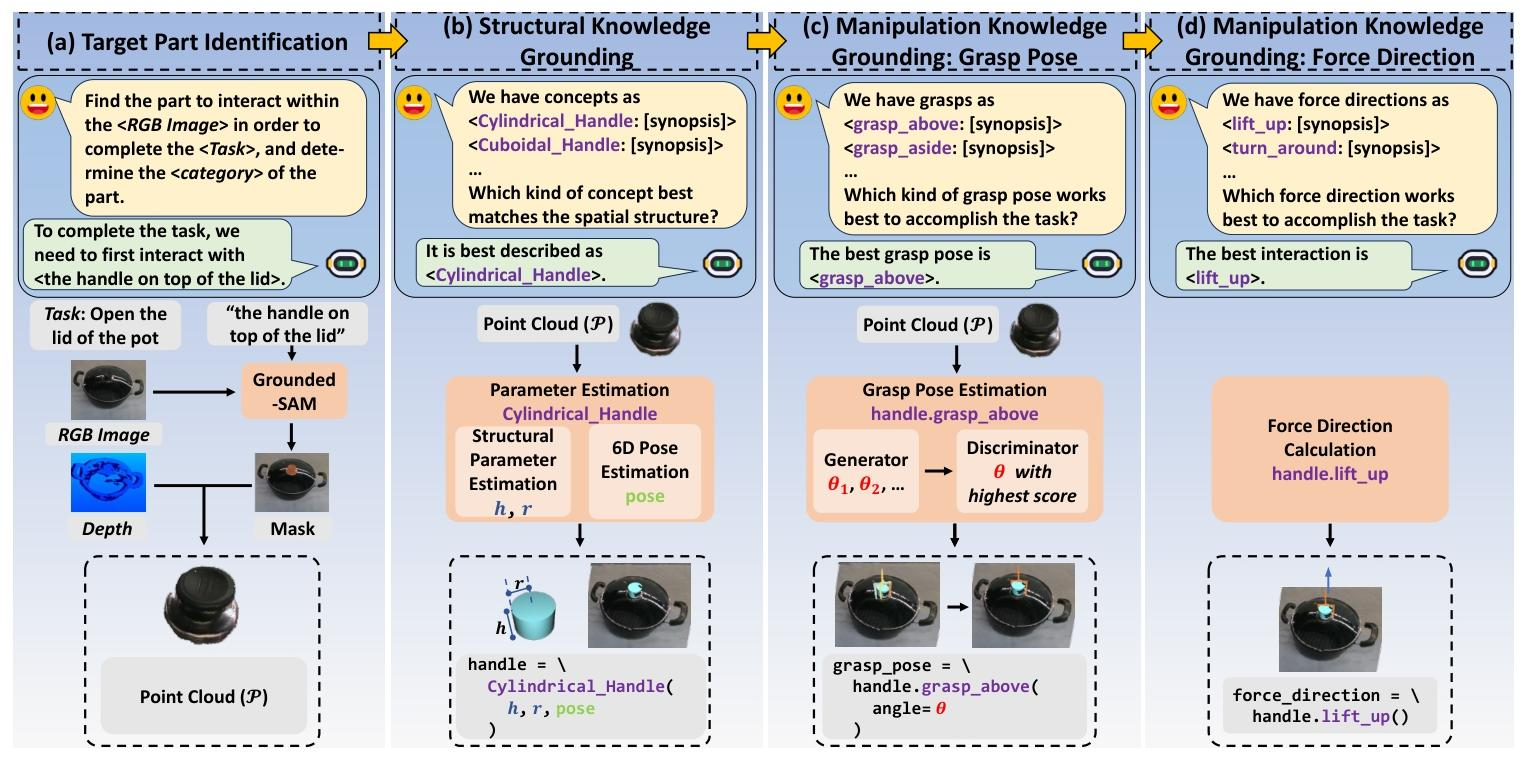
问题定义:给定物体的 RGB‑D 图像,以及自然语言形式的任务描述,机器人需要使用平行夹爪完成恰当的物理交互,以此实现任务目标。如图 3 所示,本文设计一套算法流程,以解析概念作为语义层知识到物理层知识之间的桥梁,流程包含三大步骤
- 目标部件识别
- 结构知识接地
- 操作知识接地
方法全流程
下表按运行时的执行顺序展开。解析概念库在运行前已人工定义;每个概念包含唯一标识与简介、可参数化的结构程序,以及可参数化的抓取位姿/作用力方向函数。MLLM 负责基于语义作出离散选择,点云网络和解析程序负责连续数值的估计与计算。
符号说明:以“打开锅盖”为例
以下数值只用于说明各个字母在流程中代表什么,并非论文报告的实测结果。
| 符号 | 含义 | “打开锅盖”示例 |
|---|---|---|
C | MLLM 选中的解析概念,即后续需要实例化的结构与操作程序 | C = Cylindrical_Handle,表示锅盖顶部是圆柱形把手 |
P | 从 RGB-D 图像中裁出的目标部件观测点云,位于相机或世界坐标系 | P = {(0.31, 0.09, 0.45), (0.32, 0.10, 0.46), ...},单位为 m;这些点来自锅盖把手表面 |
P* | 位姿网络预测的规范空间点云,即消除目标部件在场景中的平移和旋转后,对应到概念标准坐标系的点云 | P* = {(-0.06, 0, 0), (-0.05, 0.01, 0), ...};把手被还原到以原点为中心的标准朝向 |
s | 当前概念的全部结构参数组成的集合 | s = {H = 0.12 m, r = 0.01 m} |
H | 圆柱把手的高度或轴向长度,是 Cylindrical_Handle 的一个结构参数 | H = 0.12 m |
r | 圆柱把手的半径,是 Cylindrical_Handle 的另一个结构参数 | r = 0.01 m |
T | 从概念规范坐标系到真实世界坐标系的 6D 刚体变换,属于 SE(3) | 平移 (x, y, z) = (0.32, 0.10, 0.45) m;旋转 (roll, pitch, yaw) = (0°, 0°, 90°) |
x, y, z | 三维位置在世界坐标系三个轴上的坐标 | x = 0.32 m、y = 0.10 m、z = 0.45 m;这里的小写坐标 z 与条件 GAN 的噪声向量 z 含义不同,应根据上下文区分 |
roll, pitch, yaw | 分别绕 x、y、z 轴的旋转角,共同表示物体朝向 | (roll, pitch, yaw) = (0°, 0°, 90°),表示示例把手主要绕 z 轴旋转了 90° |
SE(3) | 所有三维刚体变换组成的集合;其中的变换同时包含旋转和平移,但不改变物体形状和尺寸 | T ∈ SE(3),表示 T 可以把标准圆柱把手刚性对齐到图像中的真实把手 |
g | MLLM 选择的抓取知识函数,只规定抓取模式 | g = grasp_above,表示从把手上方接近并抓取 |
z | 输入条件 GAN 生成器的高斯随机噪声,用于产生多组不同的候选抓取参数 | z = (0.21, -0.73, 0.35, ...),各分量从标准高斯分布采样 |
θ | 条件 GAN 估计的、与所选抓取函数相关的低维参数,并不是完整的 6D 位姿 | 对圆柱把手可令 θ = 30°,表示绕圆柱轴线的抓取位置/朝向;对论文中的 L_Handle.grasp_above,θ 具体表示沿 lever 的 offset |
G | 将最优参数 θ 代入抓取函数 g,再通过 T 变换后得到的完整 6D 夹爪目标位姿 | 位置 (0.32, 0.10, 0.49) m;姿态 (180°, 0°, 90°);机器人需要把夹爪移动到这里 |
a_F | MLLM 选择的作用力方向知识函数 | a_F = lift_up,表示抓住锅盖把手后向上提 |
F | 执行 a_F 的解析程序后得到的世界坐标系作用力或运动方向 | F = (0, 0, 1),表示沿世界坐标系正 z 方向向上移动 |
这些符号的依赖关系为:
| 目标 | 输入 | 算法(LLM/设计的算法) | 输出 |
|---|---|---|---|
| 0. 准备可计算的知识库 把常识写成机器可以直接计算的结构与操作程序 | 人工总结的物体部件结构;圆柱、长方体、球等基础几何体;常见抓取方式和施力方式 | 人工设计解析概念。每个概念包含:① 唯一名称和自然语言简介;② 用参数控制的结构程序;③ 抓取位姿函数;④ 作用力方向函数。 锅盖示例: Cylindrical_Handle 表示圆柱形把手;候选抓取知识包括 grasp_above、grasp_front、grasp_aside;候选施力知识包括 lift_up、push_clockwise、pull_backward | 按物体部件类别分组的解析概念库。每个概念既能让 MLLM 阅读其简介,也能让后续算法执行其数学程序 |
| 1. 判断任务中应与哪个部件交互 | RGB 图像 + 自然语言任务描述 锅盖示例:RGB 图像 + “打开锅盖” | **GPT-4o(MLLM)**进行语义和常识推理。提示词要求模型回答:为了完成给定任务,应与图像中的哪个部件交互?该部件属于什么类别? | 目标部件的语义描述 + 部件类别 锅盖示例:目标部件 = “锅盖顶部的把手”;类别 = handle |
| 2. 获得目标部件的像素级区域 | RGB 图像 + 步骤 1 产生的目标部件文本描述 锅盖示例:RGB 图像 + “锅盖顶部的把手” | Grounded-SAM:Grounding-DINO 根据文字提示检测目标部件的边界框,SAM 再将框内目标细化为像素级分割。论文实现中冻结 SAM,并使用 MLLM 给出的部件文本与真实边界框微调 Grounding-DINO | 目标部件的像素级 mask 锅盖示例:只覆盖锅盖顶部把手、不包含锅盖主体的二值 mask |
| 3. 从 RGB-D 观测中恢复目标部件的三维形状 | 深度图 + 相机参数 + 目标部件 mask | 用 mask 筛选深度像素,再依据相机内参将有效深度反投影到三维空间,裁出目标部件点云 | 目标部件点云 P;步骤 1 的类别 handle 同时保留,用于限定下一步只在把手概念组中检索锅盖示例:锅盖顶部把手的三维点云 P |
| 4. 判断点云对应哪一种解析结构 | RGB/目标部件视觉信息 + 部件类别 + 同类别下各解析概念的名称和简介 锅盖示例候选: Cylindrical_Handle(圆柱形)、Cuboidal_Handle(长方体形)、L_Handle(带垂直转轴的 L 形) | **GPT-4o(MLLM)**在 handle 概念组内部做离散选择,回答哪个概念最符合目标部件的空间结构。这里选择的是“结构类型”,不是连续尺寸 | 解析概念身份 C锅盖示例:选择 Cylindrical_Handle。后续所有结构和操作计算均调用该概念对应的程序 |
| 5. 估计概念的具体结构尺寸 | 目标部件点云 P + 已选概念 C | Point-Transformer 编码器 + 独立 MLP 回归头。Point-Transformer 将点云编码到隐空间;每类解析概念具有对应的 MLP 头,用于回归该概念特有的连续结构参数。训练时采用预测参数与真实参数之间的 L2 损失 | 结构参数 s,它把通用概念变成当前实例的具体形状锅盖示例:为 Cylindrical_Handle 预测高度 H 和半径 r,例如 H = 12 cm、r = 1 cm(仅为流程示意值,并非论文报告的实测值) |
| 6. 估计概念在真实世界中的位置与朝向 | 目标部件点云 P | Point-Transformer 编码器 + MLP 解码器先预测该点云在概念规范坐标系中的表示 P*。随后使用 Umeyama 算法在 P* 与观测点云 P 之间求刚体变换,并结合 RANSAC剔除错误对应点。位姿网络训练时使用规范空间点云之间的 Chamfer Distance | 6D 位姿 T:三维平移 (x, y, z) + 三维旋转 (roll, pitch, yaw);等价地表示为从概念规范坐标系到世界坐标系的刚体变换 |
| 7. 将抽象结构概念接地为真实物体实例 | 概念身份 C + 结构参数 s + 6D 位姿 T | 执行该概念的结构程序:先用 s 实例化规范坐标系中的几何体,再通过 T 将其变换到相机/机器人所在的世界坐标系 | 与真实目标部件对齐的解析概念实例 锅盖示例: Cylindrical_Handle(H, r, T);系统现在知道把手是什么形状、多大、位于哪里以及朝向哪里 |
| 8. 选择适合任务的抓取方式 | 任务描述 + 当前解析概念中所有可用抓取函数及其简介 锅盖示例候选: grasp_above = 从上方接近,grasp_front = 从前方接近,grasp_aside = 从侧面接近 | **GPT-4o(MLLM)**利用任务常识选择抓取知识。它决定抓取的语义模式,但不直接计算夹爪的精确三维位置、姿态和偏移量 | 抓取函数 g锅盖示例:选择 grasp_above,表示夹爪应从把手上方接近并抓住把手 |
| 9. 把“从上方抓”细化为可执行的精确抓取位姿 | 点云 P + 所选抓取函数 g + 高斯噪声 z | 条件 GAN进行抓取参数估计:① Point-Transformer 提取点云条件特征;② 生成器根据点云特征与噪声生成多组候选参数;③ 判别器联合编码点云与候选参数,为每组参数给出 0 到 1 的评分;④ 选择得分最高的参数;⑤ 将参数代入 g 的解析公式,并应用概念的世界位姿 T | 最优抓取参数 θ + 世界坐标中的夹爪目标位姿 G锅盖示例:确定具体抓在把手哪一段、偏移多少、夹爪绕把手旋转多少角度,最终得到机器人可执行的 G |
| 10. 选择完成任务所需的施力方式 | 任务描述 + 当前解析概念中所有可用作用力方向函数及其简介 锅盖示例候选: lift_up = 向上提,push_clockwise = 顺时针推/压,pull_backward = 向后拉 | **GPT-4o(MLLM)**根据任务目标选择作用力知识。对于“打开锅盖”,模型利用常识判断抓住把手后应将锅盖向上提起 | 作用力方向函数 a_F锅盖示例:选择 a_F = lift_up |
| 11. 将“向上提”转换成世界坐标中的数值方向 | 已接地的概念结构参数与位姿 + 抓取位姿 G + 所选作用力函数 a_F | 执行解析概念中预先定义的作用力方向程序。该程序根据概念的局部坐标轴、结构参数、6D 位姿及必要的抓取参数,程序化计算实际方向;因此 MLLM 无须直接预测精确向量 | 世界坐标中的作用力方向 F锅盖示例:把 lift_up 在概念局部坐标系中的方向变换为机器人世界坐标系中的向上提拉向量 |
| 12. 执行完整物理交互 | 精确抓取位姿 G + 作用力方向 F | 启发式机器人控制:平行夹爪先移动到 G,闭合夹爪稳定抓住目标部件,再沿 F 指定的方向移动末端执行器 | 完成目标操作 锅盖示例:夹爪从上方抓住锅盖把手并向上运动,最终打开/抬起锅盖 |
核心分工是:MLLM 不直接给出精确的 3D 数值,而是依概念简介选择“哪个部件、哪个概念、哪种抓取、哪种施力”;点云估计器、cGAN 与解析函数将这些选择转成可执行的 T、G、F。
4.5 Implementation
Grounded-SAM
Grounded-SAM 由 Grounding-DINO 和 SAM 两部分组成:
- 输入 RGB 图像统一缩放为
336 × 336。 - SAM 的参数保持冻结,不参与训练。
- 只微调 Grounding-DINO。
- Grounding-DINO 的训练输入包括 RGB 图像、可操作部件的真实边界框,以及 GPT-4o 生成的目标部件自然语言描述。
例如,对于“打开锅盖”,GPT-4o 生成提示文本“锅盖顶部的把手”,Grounding-DINO 根据该文本定位把手的边界框,SAM 再输出把手的像素级 mask。
Structural Parameter Estimation
结构参数估计网络的具体配置如下:
| 项目 | 实现 |
|---|---|
| 输入 | 目标部件点云,共 2048 个点 |
| 编码器 | Point-Transformer |
| 点云分组 | 提取 128 个点组,每组包含 32 个点 |
| Transformer 结构 | 12 层注意力层,每层使用 6 个注意力头 |
| 回归器 | 3 层 MLP |
| 输出 | 当前解析概念的结构参数 s,例如圆柱把手的高度 H 和半径 r |
| 训练损失 | 预测结构参数与真实结构参数之间的 L2 损失 |
设真实结构参数为 s,网络预测结果为 ŝ,其训练损失可写为:
例如,输入锅盖把手的 2048 点点云后,网络可以输出:
以上数值仅用于说明输出形式。
6-DoF Pose Estimation
6D 位姿估计网络与结构参数估计器采用相同的 Point-Transformer 主干结构,但它不直接回归 6D 位姿,而是预测目标点云在解析概念规范坐标系中的点云 P*。
训练时,利用真实 6D 位姿把输入点云 P 变换到规范坐标系,得到真实规范点云;再计算预测规范点云与真实规范点云之间的 Chamfer Distance:
其中:
P̂*是网络预测的规范空间点云。P*gt是根据真实 6D 位姿,将输入点云变换到规范空间后得到的监督信号。- Chamfer Distance 衡量两组点云之间的几何差异。
推理时,再利用 Umeyama 算法和 RANSAC,根据 P* 与观测点云 P 的对应关系求出刚体变换 T。
Grasp Pose Estimation
抓取参数估计采用条件 GAN。生成器和判别器中的 Point-Transformer 与 MLP,使用与结构参数估计器相同的网络配置。训练数据已经包含正、负两类抓取参数样本,因此训练分为两步:先训练判别器,再训练生成器。
1. 训练判别器
判别器损失为:
各个符号的含义为:
| 符号 | 含义 | 抓取锅盖把手的例子 |
|---|---|---|
x | 一组抓取参数样本 | x = θ = 30°,表示绕圆柱轴线选择 30° 处的抓取位置/朝向 |
y | 条件信息,即目标部件点云经过 Point-Transformer 得到的视觉特征 | 锅盖顶部把手点云 P 的编码特征 |
p_data+ | 正抓取参数的数据分布 | 无碰撞、夹爪能够稳定夹住把手并抬起锅盖的参数样本 |
p_data- | 负抓取参数的数据分布 | 夹空、发生碰撞或无法稳定抓住把手的参数样本 |
D(x|y) | 判别器在条件 y 下认为参数 x 是有效抓取参数的概率,取值范围为 0 到 1 | 若 D(30°|y) = 0.93,说明该候选参数具有较高的可行性 |
该损失使判别器对正样本输出接近 1 的分数,对负样本输出接近 0 的分数。
2. 训练生成器
生成器损失为:
其中:
| 符号 | 含义 | 抓取锅盖把手的例子 |
|---|---|---|
z | 输入生成器的随机噪声 | z = (0.21, -0.73, 0.35, ...) |
p_z | 噪声 z 的分布,论文采用高斯分布 | z 从标准高斯分布中采样 |
G_gen(z|y) | 生成器在点云条件 y 下,根据噪声 z 生成的抓取参数;这里写成 G_gen,用于区别前文表示最终抓取位姿的 G | 生成候选角度 θ = 30° |
D(G_gen(z|y)) | 判别器对生成参数给出的可行性评分 | 对候选角度 30° 给出 0.93 的评分 |
最小化该损失会推动生成器产生能够被判别器评为正样本的抓取参数。推理时,生成器利用不同噪声生成多组候选参数:
判别器选择评分最高的候选参数:
最后,将最优参数代入由 MLLM 选中的解析抓取函数,计算完整的世界坐标夹爪位姿:
需要注意,条件 GAN 输出的是 θ* 这样的低维抓取参数,而不是直接输出完整的 6D 抓取位姿 G;完整位姿由解析概念中的抓取函数结合结构参数 s 和世界位姿 T 计算得到。