EBench: Elemental Diagnosis of Generalist Mobile Manipulation Policies
任务集合能够同时覆盖长时序、灵巧操作以及移动操作场景
且具备完善的评测机制,支持细粒度分析,而非仅输出排行榜上的单一标量数值
满足
-
基础设施统一化
开源代码库,整合双轨数据合成流水线 + 可组合评分库 + 分布式评估执行器
-
任务广谱 + 能力细粒度
26 个任务横跨三类操作范式,每个任务沿 5 个维度(场景、原子技能、时序、精度、操作模式)标注
-
分布外/泛化可控评估
通过资产级隔离,构造 4 个泛化维度(未见背景、未见物体、指令改写、混合扰动),训练 / 测试资产池完全不重叠
任务 与 Episode 定义
一个任务的核心是操作目标(由语言指令描述),而不是固定的初始状态。一个 Episode 是该任务的一次具体执行:物体位置、物体外观、场景背景或指令表述可以变化,但要完成的操作目标不变。
| Episode | 初始状态 / 指令变化 | 任务目标 |
|---|---|---|
| #1 | 杯子在桌子左上角,托盘在右边 | 把杯子放到托盘上 |
| #2 | 杯子在桌子中间,托盘在左边 | 把杯子放到托盘上 |
| #3 | 杯子是红色马克杯,背景是厨房 | 把杯子放到托盘上 |
| #4 | 杯子是透明玻璃杯,背景是客厅 | 把杯子放到托盘上 |
| #5 | 指令改写为 place the mug onto the serving plate | 把杯子放到托盘上 |
BenchMark
任务覆盖
分为三大任务类别:
- 移动抓取‑放置任务(10 个移动类任务,每个回合 600‑1000 仿真步)
- 移动长时序任务(9 个多阶段移动序列任务,3000‑5000 仿真步)
- 桌面灵巧精密任务(7 个固定基座任务,1500‑3500 仿真步,涵盖亚厘米级插入、对齐以及双臂协同操作)
物理仿真频率为 60 赫兹,因此耗时最长的任务大约对应机器人 83 秒的实际运行时长。
仿真步:仿真引擎进行一次完整物理状态更新的最小时间单位。可以把它理解为仿真世界里的 "一帧"。
对于不同维度的覆盖
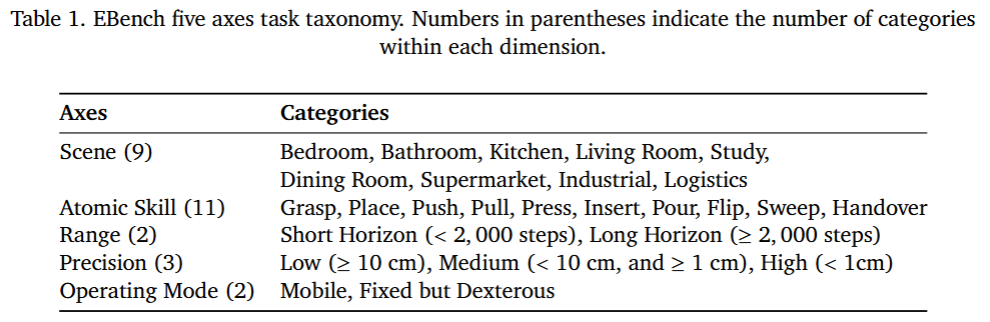
所有任务为搭载在移动底座上的双臂机器人共用一套统一的动作空间:每条机械臂既可以接收6 自由度关节位置指令,
也可以接收6 自由度末端执行器位姿指令, 同时每条机械臂附带独立的夹爪开度控制
机器人底座接收三维速度指令(平面 x、y 方向速度以及偏航角速度即底座旋转角速度)
数据生成
难点
- 精密灵巧任务,难以通过代码算法生成,必须人类专家操作
- 长时间任务人类专家难以保证不出错,采集成本高
- 对于移动操作,人类难以操作,因为要同时控制两个机械臂+一个底座
Two complementary collecting streams
A. 运动学同构的主从跟随系统:
即人类专家收集,包括拧螺丝,捡咖啡豆类似任务
B. 关键帧位姿与 cuRobo:
标注人员转而指定一组稀疏的末端执行器关键帧位姿;对于涉及移动的任务,还会同步给出底座路径点。随后 cuRobo(Sundaralingam 等人,2023)求解出连接上述关键点的无碰撞、最小加加速度轨迹
这份后训练数据集总计包含 91.4 小时的演示数据,最终共 6600 个任务episode,数据采用 LeRobot 格式组织。每项灵巧精密任务提供 400 个人类遥操作采集的episode,每项移动抓取‑放置任务提供 200 条运动规划生成的episode,每项长时序任务提供 200 条运动规划生成的episode
Generalization Dimension
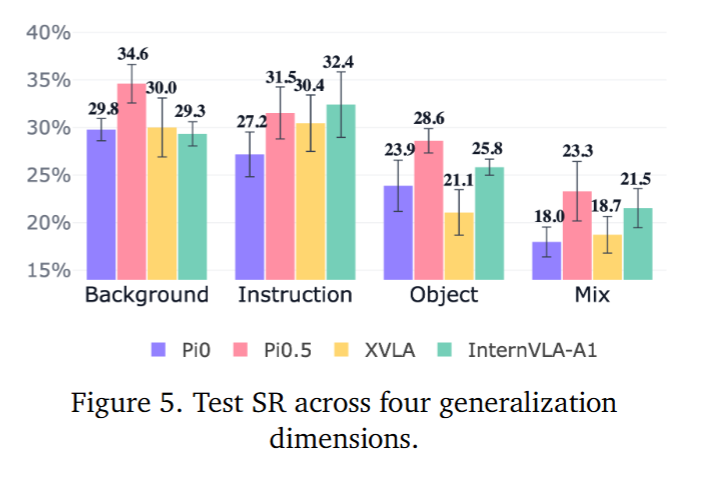
EBench 在评测中设置 4 个泛化维度:
(1) 背景泛化:将场景纹理与光照替换为未见过的变体,物体与语言指令保持不变。
(2) 物体泛化:把每个待操作物体替换为同一类别下、几何形态不同且未见过的物体实例。
(3) 指令泛化:对每一条自然语言指令做同义改写,但保留任务的操作目标不变。
(4) 混合泛化:同时施加背景、物体、指令三类扰动。
数据集划分
| 数据集 | 规模 | 用途 | 资产来源 |
|---|---|---|---|
| 训练集(Train) | 6,600 个 episode(91.4 小时) | 用于模型训练 / 微调 | 训练资产池 |
| 验证集(Validation) | Val-Train:130 个;Val-Unseen:154 个 | 训练中监控性能、调参和早停 | Val-Train:训练资产池;Val-Unseen:未见物体(物体替换为未见实例,背景和指令大概率还是训练分布内的) |
| 测试集(Test) | 510 个 episode | 不参与训练,仅用于最终评估 | 测试资产池,与训练资产池完全不相交(四个维度的泛化) |
Evaluation Primitives 评估原语
选择能从仿真器状态里直接读出来的 "基础事实"
- 不可再分
- 底层生成
- 自由组合
| 原语 ID | 原语内容 | 计算方式 |
|---|---|---|
| P1 | 夹爪夹住了杯子 | 夹爪宽度 < 阈值 AND 杯子在夹爪包围盒内 |
| P2 | 杯子离开了桌面 | 杯子底部高度 > 桌面高度 + 1 cm |
| P3 | 杯子在托盘正上方 | 杯子水平坐标在托盘范围内 AND 杯子高度 > 托盘高度 |
| P4 | 杯子倾斜 < 15° | 从杯子姿态计算倾斜角 < 15° |
| P5 | 杯子在托盘上 | 杯子底部接触托盘 AND 水平坐标在托盘范围内 |
| P6 | 夹爪松开了 | 夹爪宽度 > 阈值 |
| P7 | 杯子稳定 | 杯子速度 < 阈值 AND 持续 0.5 秒 |
阶段 条件(原语的 AND 组合) 完成后得分 阶段 1:抓住杯子 P1 AND P2 +33% 阶段 2:举到托盘上方 P3 AND P4 +33% 阶段 3:放下并稳定 P5 AND P6 AND P7 +34%
实验结果
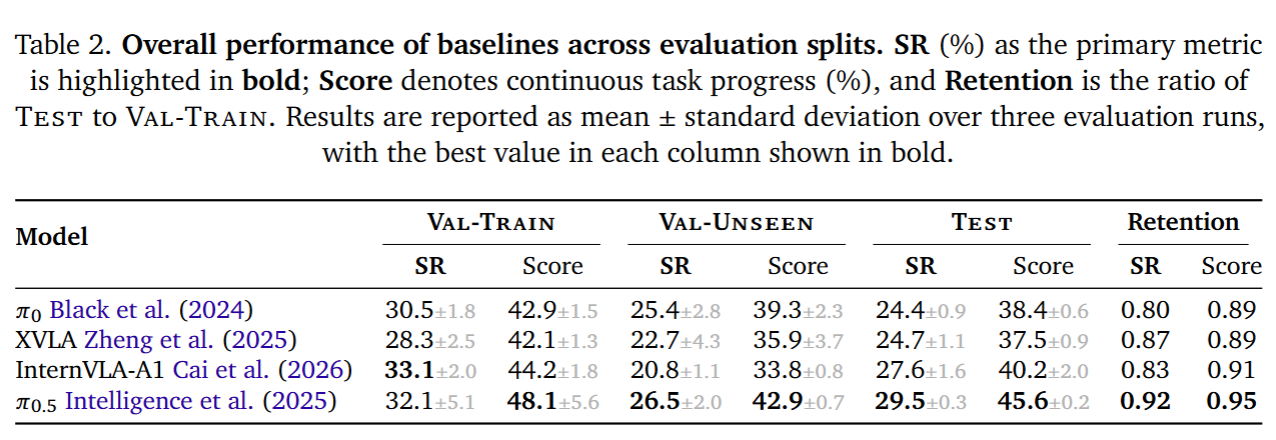
每个模型测三次 得到 平均值±标准差
SR:success rate
Score:任务进度得分
Retention 为测试集结果与 Val‑Train 集结果的比值
Experiment Setup
评估模型
4个 VLA 模型
- XVLA
- InternVLA-A1
所有模型均基于预训练权重,在同一套 EBench 训练数据集上执行微调,且采用完全一致的实验配置
- 200K gradient steps
- batchsize = 128
- AdamW
- lr =
Capability Profiling 能力画像
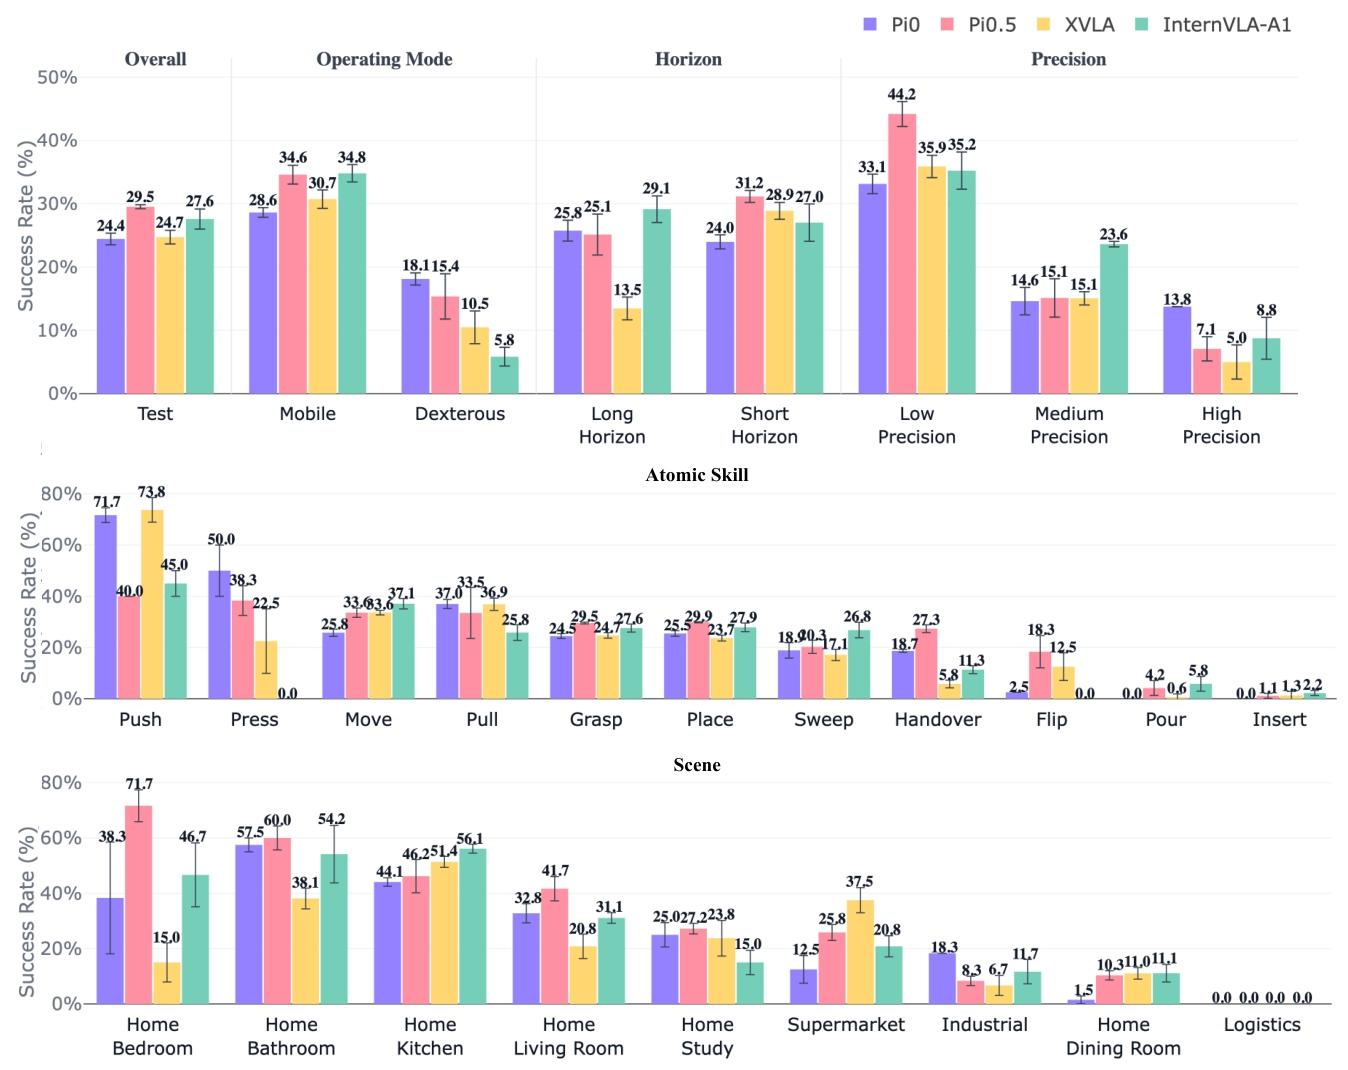
后训练与评估流程
动作分块预测预测视界为 50 个时间步;开环执行视界为 30 步:策略在每次重规划时刻预测一段长度为 50 步的动作块,但仅向环境执行前 30 个动作,之后再发起下一轮预测。由此产生的 20 步前瞻缓冲,可以抵消模型推理带来的延迟,同时避免引入闭环不稳定问题
这里叫开环执行,应该是说30步中间不管观测,一口气执行完毕
使用分布式评估工具包,在 8 张 RTX 4090 显卡上完成一轮完整验证集评估大约需要 30 分钟。在相同硬件条件下,跑完整套基准测试(验证集 + 测试集)耗时不超过两小时,便于快速迭代开发
附录补充
Task-Level Complementarity and Hard Tasks
-
不同模型有很强的互补性
-
shop、bottle、peg_in_hole、collect_coffee_beans、flip_cup_collect_cookies 这些任务在多个评测快照下基本都在 5% SR 以下。
Controlled Breakdown Analysis
EBench 的每个任务同时带有多个标签。比如:
- 一个 Mobile 任务,可能同时也是 Low Precision
- 一个 Fixed 任务,可能同时也是 High Precision
Mobile 比 Fixed 好 的差距,可能其实是精度差异导致的,而不是操作模式本身的差异。
Permutation Test
第 1 步:计算观测到的组间差异。 以任务成功率(SR)为指标,计算 Mobile 任务与 Fixed 任务的平均成功率之差:
其中,Mobile 组包含 19 个任务,Fixed 组包含 7 个任务。以 InternVLA-A1 为例,观测差异为 。
第 2 步:构造零分布(null distribution)。 在零假设下,任务属于 Mobile 还是 Fixed 不应影响 SR。为模拟这一情形,随机置换 26 个任务的组别标签,同时保持两组任务数量分别为 19 和 7 不变;随后计算置换后两组的平均 SR 差异 。重复 10,000 次,即得到 10,000 个随机差异值所构成的零分布。
第 3 步:计算双侧 值。 统计零分布中绝对差异不小于观测绝对差异的比例:
例如,对 InternVLA-A1 而言,若 10,000 次置换中约有 80 次满足 ,则 。这表示:在两类任务本无系统性差异的前提下,出现当前或更极端差异的概率约为 0.8%。
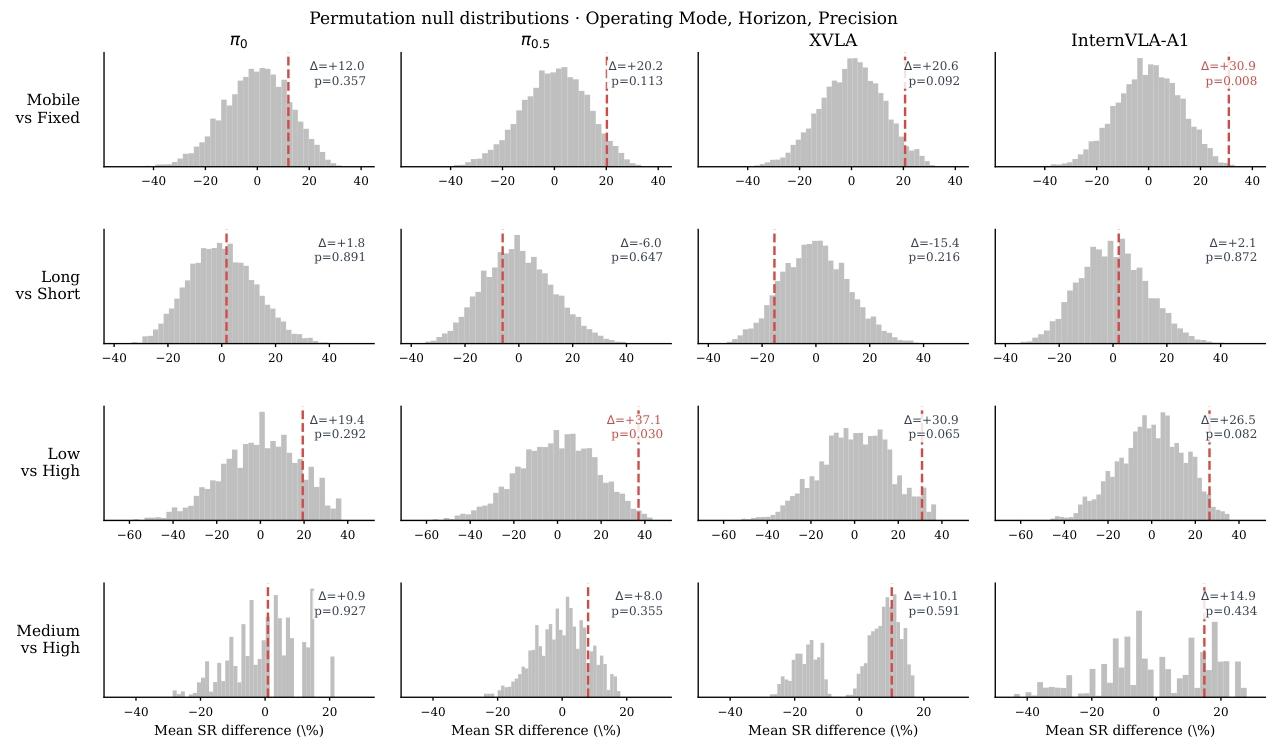
但是这里似乎只能说明
但不能说明
Regression:控制任务属性
若要估计控制任务属性后 Mobile 的独立关联,可在任务层面进行多元回归。对每个任务 ,令 ,并将 Mobile、任务时长(Long)、精度等级(如 Low / Medium Precision)、场景、原子技能等属性编码为特征:
其中, 表示在 Precision、Horizon、Scene 等已纳入模型的条件下,Mobile 与 SR 的剩余关联;它仍是控制变量后的相关性估计,而非严格的因果效应。
Summary
3大类任务 分5个纬度 加3+1种泛化 再分成4个集 非常完备的bench了
可是附录的测试好像没有很好的解决问题