ASPIRE: Agentic /Skills Discovery for Robotics
随着 ASPIRE 处理的任务不断增多,持续扩充的技能库让系统的环境适配速度越来越快
Intro
现有执行环境多数仅能提供粗粒度的任务层级反馈 调试机器人程序本身极具难度 故障可能源于多个相互耦合的模块 难以定位归因
采用 code ad policy 范式
回放执行记录 > 定位故障模块 > 修改代码 > 总结经验为可复用策略
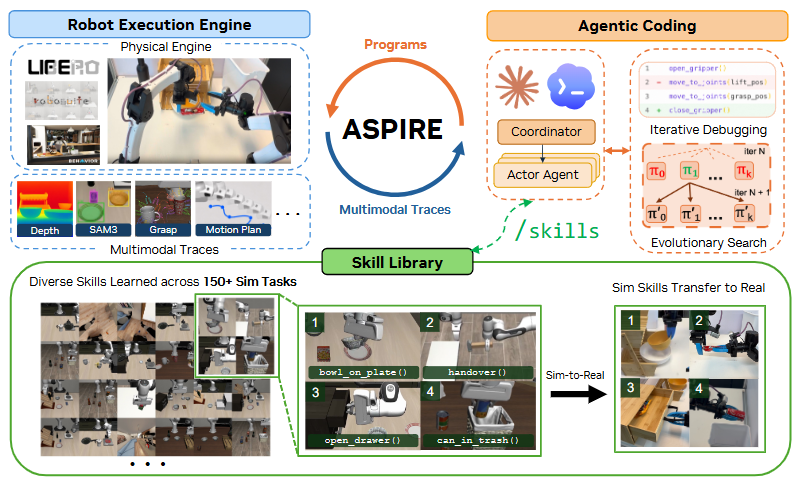
架构
-
闭环执行的机器人引擎
-
持续扩充技能库
-
进化搜索流程
协调器‑执行者(coordinator‑actor)架构
中央协调器负责管理共享技能库,并为各个任务分派执行者编码智能体
每一个 actor 都在机器人执行引擎内部完成机器人程序的编写、运行、故障诊断与修复工作
actor 之间不交互对话 通过技能库共享知识
Method
机器人执行引擎
需要执行过程证据来调试智能体 用于定位故障 但是如果信息过多 又干扰智能体判断原因
机器人引擎会记录每一个原语对应的多模态轨迹 把轨迹给智能体 然后执行智能体给出的修复代码 形成闭环
每一次调用 都会记录 API,输入输出,返回状态,相关多模态证据(RGB,抓取候选位姿...)
智能体不接收完整视频帧 每次仅保存原语调用执行前后的图像帧以及对应的叠加图层和返回值
原语就是封装好的基础功能函数 / API,是机器人可以直接调用、用来完成一小块基础能力的最小单元
叠加图层:额外画上去的一层标记 算法生成的可视化 如SAM图像掩码分割,抓取候选叠加,运动轨迹,锚框
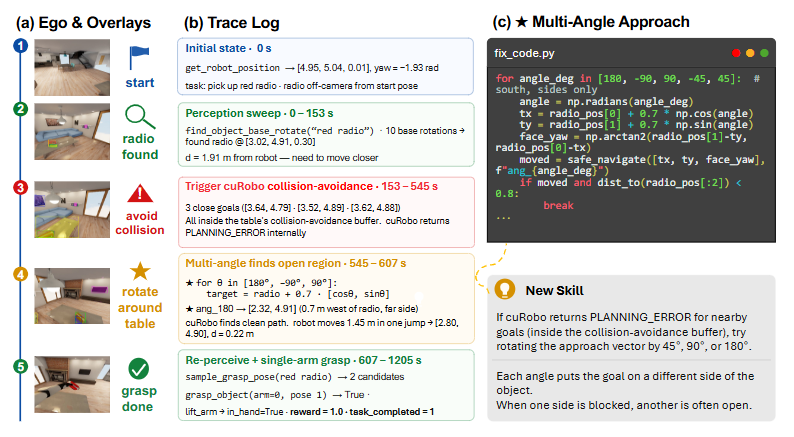
这里 4 和 5 是执行完修补程序之后产生的成功行为轨迹
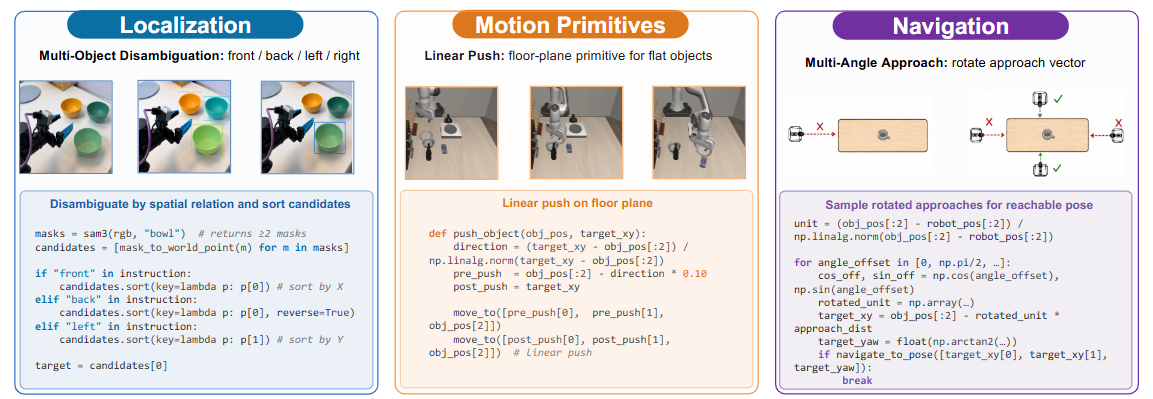
masks = sam3(rgb, "bowl")        # SAM3分割,输出≥2个碗的掩码
candidates = [mask_to_world_point(m) for m in masks] # 全部转为世界坐标 输入 mask

# p[0]:x p[1]:y P[2]:z
if "front" in instruction:
    candidates.sort(key=lambda p: p[0])        # 按X轴排序,取靠前
elif "back" in instruction:
    candidates.sort(key=lambda p: p[0], reverse=True)
elif "left" in instruction:
    candidates.sort(key=lambda p: p[1])        # 按Y轴排序

target = candidates[0]   # 排序后的第一个,就是指令描述的物体
技能库
技能由经过验证的修复方案归纳生成 协调器仅将具备复用价值的模式收录至共享库
每项技能都以精简的上下文引导形式保存,包含故障特征、适用触发条件、修复策略;必要时还附带一份具有代表性的代码概要
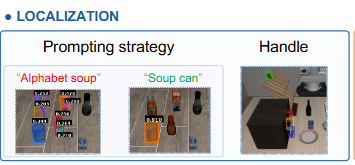
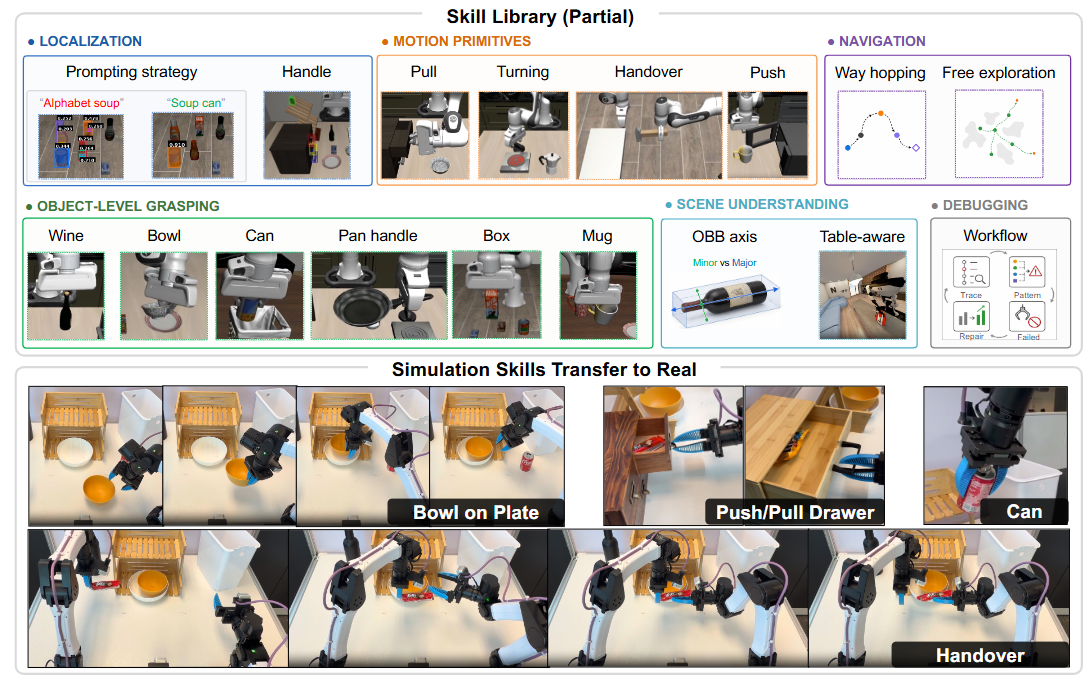
这里左边两张图 可以感知prompt写的好不好 比如左边就没法定位到具体的一个目标 右边的可以
右边的Handle 就是专用于把手的定位技能
以下就是各种技能 任务中形成的
进化搜索
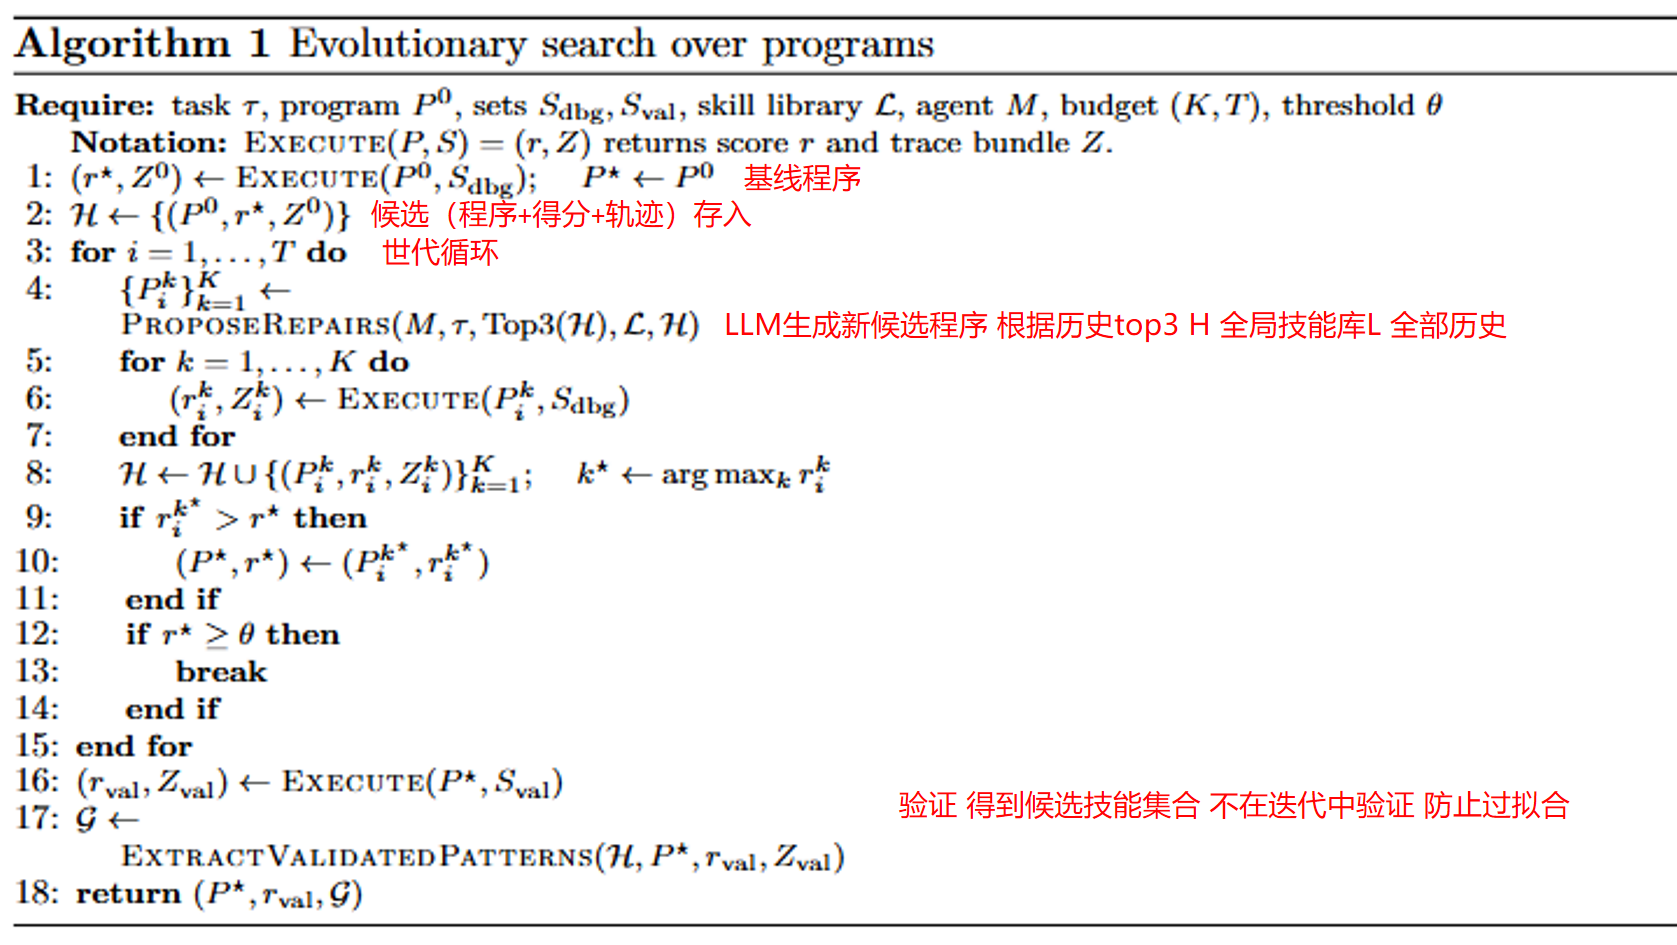
进化搜索把机器人程序本身当作搜索对象。它借鉴遗传算法的“种群、择优、迭代”思路:每一轮由智能体提出一批不同的候选程序,在调试场景中逐个执行,根据任务得分和执行轨迹保留更好的方案,再据此提出下一轮候选。这样可以同时探索不同修复思路,减少只围绕一个失败方案反复打补丁、陷入局部修复循环的情况。
这里的“进化”是类比:伪代码没有传统遗传算法明确的基因编码、交叉和变异算子。候选程序由编码智能体根据任务、历史候选、失败轨迹和技能库生成;环境执行结果负责评分与诊断。
伪代码变量
| 符号 | 含义 |
|---|---|
τ | 当前要完成的任务 |
P⁰ | 初始程序,即开始搜索前已有的基线程序 |
S_dbg | 调试场景(seeds)集合;候选程序在这些场景里执行、诊断和迭代 |
S_val | 验证场景集合;在搜索结束后评估当前最佳程序,检查它在未用于迭代的场景中是否也有效 |
ℒ | 已积累的技能库,包含可复用的故障特征、触发条件和修复策略 |
M | 负责分析历史并生成候选程序的编码智能体(论文实验中为 LLM coding agent) |
K | 每一代生成并评估的候选程序数量 |
T | 最大迭代轮数,也就是搜索代数预算 |
θ | 搜索阶段的目标分数阈值;当当前最佳调试分数 r* 达到它时,就不再生成新一代候选 |
Execute(P, S) | 在场景集合 S 中执行程序 P,由仿真/任务评测返回任务分数 r 和执行轨迹包 Z |
r | 程序在对应场景上的标量任务分数;由环境或基准任务的奖励/成功判定计算,不是 LLM 主观打分;具体量纲取决于任务 |
Z | 执行轨迹包,包含诊断程序所需的执行记录和证据 |
ℋ | 搜索历史,保存已评估的程序、得分和轨迹,格式为 (P, r, Z) |
Pᵢᵏ、rᵢᵏ、Zᵢᵏ | 第 i 代第 k 个候选程序,以及它的得分和轨迹 |
Top3(ℋ) | 从历史 ℋ 中选出的得分最高的三个程序及其相关记录,作为提案参考 |
P*、r* | 目前找到的全局最佳程序及其调试得分 |
k* | 当前这一代得分最高的候选编号 |
r_val、Z_val | 最佳程序在验证场景上的分数和轨迹 |
𝒢 | 从搜索与验证结果中提取、通过验证的可复用技能模式 |
r 是什么分数?θ 为什么能让搜索提前停止?
r 是执行引擎对程序运行结果给出的数值任务分数。执行引擎负责运行程序并收集结果;真正计算分数的是仿真环境或基准任务中定义的 reward / success evaluator,编码智能体负责提出程序和分析轨迹,不负责凭感觉给程序打分。论文附录将每次 trial 的 reward 记录为标量任务分数,并同时记录任务是否完成;不同任务的 reward 设计可能不同。ASPIRE 论文:算法与实验设置
θ 是研究者为当前任务设定的“调试集上已经够好”的停止目标。达到它后继续搜索的收益可能不值得额外的仿真运行与 token 开销,所以算法跳出候选生成循环;之后仍会在独立的 S_val 上验证,并不能把调试集达标当作泛化成功的证明。
下面是一个便于理解的二元成功率示例,不是论文规定的统一分数或阈值:假设一个任务在 5 个调试场景运行,每个场景成功记 1、失败记 0,那么 r 可以定义为成功场景数除以 5。若当前最佳程序在 5 个场景中成功 4 个,则 r* = 4/5 = 0.8;若该任务设 θ = 0.8,就满足 r* ≥ θ,提前结束搜索。换成实际任务时,应使用该环境或 benchmark 定义的 reward 计算方式,θ 也要按相同量纲设定。
搜索流程
| 步骤 | 伪代码操作 | 直观解释 |
|---|---|---|
| 1. 评估基线 | 在 S_dbg 上执行 P⁰,得到 r* 和 Z⁰,并令 P* = P⁰ | 先测初始程序表现,作为后续比较基准 |
| 2. 记录历史 | 初始化 ℋ = {(P⁰, r*, Z⁰)} | 保存程序、分数和诊断轨迹,供智能体后续参考 |
| 3. 提出候选 | 每一代调用 ProposeRepairs(M, τ, Top3(ℋ), ℒ, ℋ) 生成 K 个候选 | 智能体结合任务、历史高分程序、完整失败记录和技能库,提出多种程序方案 |
| 4. 执行候选 | 把每个 Pᵢᵏ 在 S_dbg 上执行,收集 (rᵢᵏ, Zᵢᵏ) | 仿真不仅给出成败/得分,也提供轨迹,帮助判断失败原因 |
| 5. 更新历史与最优解 | 把这一代结果加入 ℋ;取本代最高分候选 k*,若优于 r* 就更新 (P*, r*) | 保留所有经验,同时更新迄今最好的程序 |
| 6. 判断停止 | 若 r* ≥ θ,提前结束;否则继续,直到达到 T 代 | 当前最佳程序已达到预设的调试目标时,省去后续候选评估;阈值是停止条件,不代表已通过独立泛化验证 |
| 7. 独立验证 | 在 S_val 上执行 P*,得到 r_val 和 Z_val | 检查程序是否只适配了调试场景,减少对有限调试 seeds 的过拟合 |
| 8. 提炼技能 | 根据历史、最佳程序和验证结果提取 𝒢 | 只把验证有效、可复用的修复模式整理进技能库 |
其中 Top3(ℋ) 让新方案参考已知的高分程序,完整的 ℋ 则保留失败轨迹和其他尝试。两者配合,既利用有效经验,也让智能体有机会避开失败过的路线。
为什么在仿真中搜索?
搜索过程要反复运行多份由智能体生成的机器人程序,并主动尝试不同策略。在论文的实验设置中,进化搜索用于仿真:仿真可以低成本地重置场景、重复评估候选,也更容易控制安全风险。这不是算法在理论上只能用于仿真,而是论文采用的搜索与验证方式;真实机器人部分使用的是仿真中发现并验证过的技能作为上下文指导,再由智能体适配真实机器人的 API,而不是直接在实机上做同样规模的进化搜索。ASPIRE 论文
Experiment
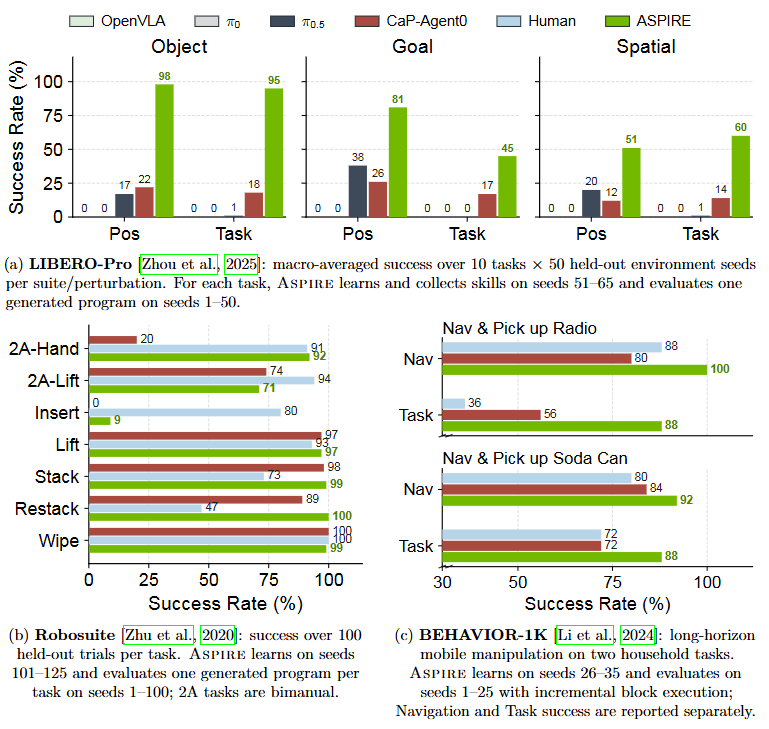
仿真基准测试中:Claude Opus 4.6 基于 Cap-X 框架(MuJoCo上)
真实机器人迁移:用OpenAI Codex GPT-5.5 在YAM双臂操作实验平台上
选取在仿真平台习得的三项技能 易拉罐拾取、碗放置到盘子上、抽屉推拉 作为上下文给智能体
此处 API 完全不同 但同样开放ASPIRE多模态接口 智能体自主检查调试运行 无需人工
实验对比:有无仿真技能技能在上下文
评测指标:首次成功消耗token量 + 真实机器人的流出集成功率
测评协议
一个种子 = 某一类任务一套场景布局
ASPIRE 使用少量调试种子 产出一套代码 这一套用于跑所有留出的评估seed
CaP-Agent0 对每个留出评估seed 重新生成一套代码 来测试
对于 BEHAVIOR‑1K 长任务 ASPIRE 采用增量块执行
不一次性生成全部代码;跑一块,看当前多模态 trace 轨迹,再生成下一小块代码,一步一步推进长任务
仿真结果
实机迁移结果
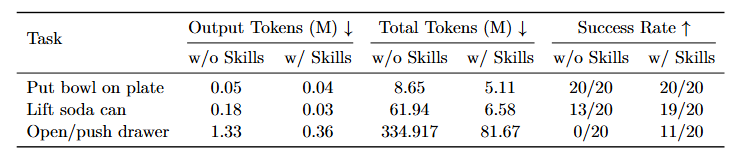
- Output Tokens (M):输出token
- Total Tokens (M):输入+输出
- w/ = with
- w/o = without
Ablation Studies
- 机器人引擎
- 进化搜索
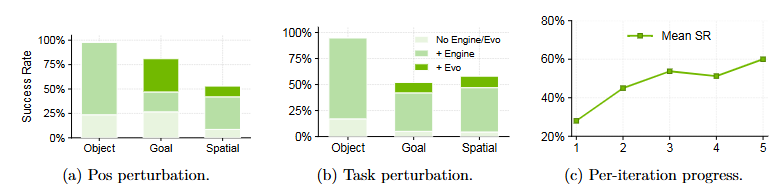
可见 Engine 带来巨大提升
在 Object 扰动上,evo几乎没有能再带来提升了,但是在其他高难度任务有提升
Appendix
A. Skill Library Details
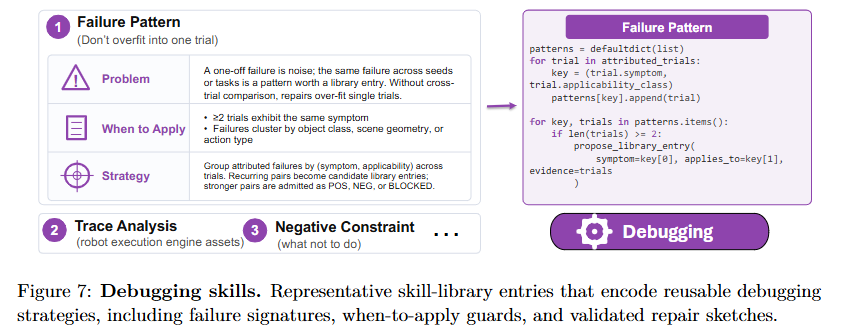
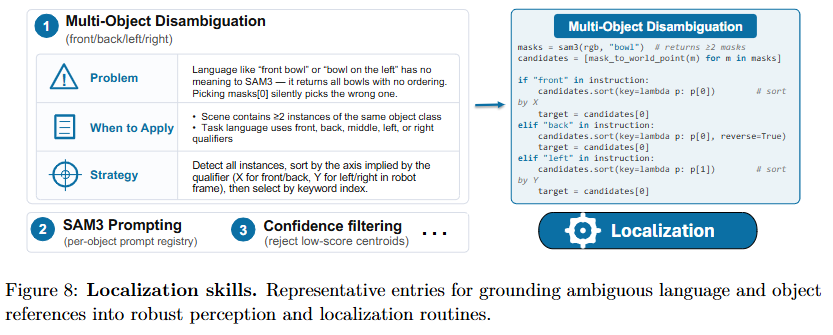
我查看了 localize.md 目前没有统一的 Problem / When to Apply / Strategy 三个字段 结构和图里不完全一样
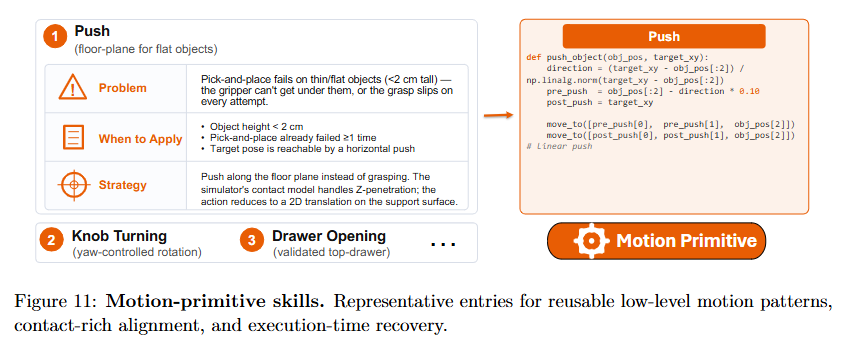
源码仓库阅读理解
Skill Lib 部分
name: grasp description: Structural template for pick-and-place programs. Covers the standard grasp-lift-place code skeleton, make_topdown_quat(), pre-grasp/lower/close sequence, and placement pattern. No task-specific strategies — those are discovered through experiment.
Grasp — Code Template
This skill provides the structural skeleton for pick-and-place programs. Task-specific strategies (object-specific offsets, SAM3 prompts, placement geometry) are discovered through experiment and added here as the skill library grows.
Standard Pick-and-Place Template 节选
import numpy as np
from scipy.spatial.transform import Rotation

def make_topdown_quat(yaw_deg=0):
    """Top-down gripper orientation, rotated yaw_deg around Z."""
    R = Rotation.from_euler('z', yaw_deg, degrees=True).as_matrix() @ \
        np.array([[1, 0, 0], [0, -1, 0], [0, 0, -1]])
    q = Rotation.from_matrix(R).as_quat()  # xyzw
    return np.array([q[3], q[0], q[1], q[2]])  # wxyz for API

# --- Observe ---
obs = get_observation()
cam = obs["agentview"]
rgb = cam["images"]["rgb"]
depth = cam["images"]["depth"]
depth_img = depth[:, :, 0] if len(depth.shape) == 3 else depth
K = cam["intrinsics"]
E = cam["pose_mat"]

# --- Localize pick object via SAM3 ---
masks = segment_sam3_text_prompt(rgb, "<object prompt>")
if not masks:
    raise RuntimeError("SAM3: no masks for pick object")
best = max(masks, key=lambda d: d["score"])
obj_pts = mask_to_world_points(best["mask"].astype(np.uint8), depth_img, K, E) # 世界点云生成
obj_center = obj_pts.mean(axis=0) # 物体粗略中心

# --- Grasp via GraspNet (preferred for irregular objects) ---
grasp_poses, grasp_scores = plan_grasp(depth, K, best["mask"]) # 由深度图 相机内参 物体像素区域规划一个抓取点 是一个深度模型
best_grasp_world, _ = select_top_down_grasp(grasp_poses, grasp_scores, E) # 从上方往下抓
# 若找不到从上往下 那就选score最高的
if best_grasp_world is None:
    best_grasp_world = E @ grasp_poses[grasp_scores.argmax()]
grasp_pos, quat = decompose_transform(best_grasp_world) # 转换机器人可读取

open_gripper()
goto_pose(grasp_pos, quat, z_approach=0.15) # 移动到抓取点上方 15cm
goto_pose(grasp_pos, quat) # 下探
close_gripper() # 闭合
Key Conventions
深度的 shape 提示 Depth normalization — always do this before any 3D call:
depth_img = depth[:, :, 0] if len(depth.shape) == 3 else depth
这里意思是选择 sam 分割出来物体中置信度最高的 SAM3 result — list of dicts, pick highest score:
best = max(masks, key=lambda d: d["score"])
obj_pts = mask_to_world_points(best["mask"].astype(np.uint8), depth_img, K, E)
GraspNet TCP offset — plan_grasp already applies a 0.12 m offset along the grasp Z axis
to its returned poses; do not add another TCP compensation on top of GraspNet grasps.
GraspNet grasp selection — use select_top_down_grasp, not a manual z-axis loop:
grasp_poses, grasp_scores = plan_grasp(depth, K, mask)
best_grasp_world, _ = select_top_down_grasp(grasp_poses, grasp_scores, E)
if best_grasp_world is None:
    best_grasp_world = E @ grasp_poses[grasp_scores.argmax()]
IK guard — always check if joints is not None before move_to_joints.
TCP offset for placement: goto_pose(pos, quat) moves the WRIST to pos; fingertips extend below the wrist. Calibrate per robot/gripper config and adjust placement Z accordingly.
Top-level call — if you define a run() function, call it at the end:
def run():
    ...
run()
Gripper width thresholds — add validated per-object thresholds here as you discover them:
| Object | Good grasp (gw >) | Air grasp (gw <) | Notes |
|---|
Object Geometry Utilities
# Z range (grasp height tuning)
z_min, z_max = obj_pts[:, 2].min(), obj_pts[:, 2].max()
height = z_max - z_min

# OBB (orientation-aware bounding box)
obb = get_oriented_bounding_box_from_3d_points(obj_pts)
# Keys: "center" (3,), "extent" (3,), "R" (3x3 rotation matrix)
obb_center = obb["center"]
这里则讲述了点云均值不稳定的情况下 如何根据别的来决定如何抓取
Prompt 部分
EvoSearch
/evosearch/main-agent-prompt.md
- Stage 1: 在 seeds 51–65 上做 Evolutionary Search
- Stage 2: 对最佳代码做 seeds 1–50 的评估
Guide
- What:任务概述,例如运行 Evolutionary Search,对八个候选程序进行迭代调试。
- Stage 1:使用 seeds 51–65 试错迭代,对应前文的
S_dbg。 - Stage 2:使用 seeds 1–50 验证和测试,对应前文的
S_val。
- Stage 1:使用 seeds 51–65 试错迭代,对应前文的
- Why:解释原因。
- Subagent template:提供 actor prompt template。
初始化代码提示
提供用于检查服务端口(LLM、VLM、SAM3、GraspNet)的代码:
for p in 8114 8115 8116; do
  echo "port $p: $(curl -s -o /dev/null -w '%{http_code}' --max-time 3 http://127.0.0.1:$p/health)"
done
并讲解检查结果。
输出目录结构
outputs/
  claude_evosearch/
    <suite>/<task>/<run_id>/       # Evolutionary Search iteration artifacts (existing convention)
      task_analysis.md
      iter_00/ iter_01/ ...
        candidate_A/code.py
        iter_summary.json
    <suite>/<task>/
      evosearch_best_code.py       # Best code from Stage 1 iterations (written by subagent)
      findings.md                  # Subagent summary + Stage 2 result

  aspire_evosearch_eval/
    <suite>/<task>/trial_*_sandboxrc_*_reward_*_taskcompleted_*/  # Stage 2 results
任务选取
- 选择成功率低于 80% 的任务。
- 按照 Goal Task → Goal Swap → Spatial Swap → Spatial Task(后续)分配任务。
Workflow
- 检查进程。
- 检查空闲 GPU。
- 将任务分配给子 agent。
- 完成后读取结果,并重新分配任务。
停止
- 所有任务在 seeds 51–65 上的成功率达到 80% 以上。
- 完成五轮迭代。
- 连续两轮的成功率提升不到 5%。
/evosearch/subagent-prompt.md
Stage 1: Evolutionary Search Iterations on Seeds 51–65
- 检查
evosearch_best_code.py是否存在 存在就跳到 what to return 版块 + BDDL remap check - 读 skill + baseline (fix_code.py fix-loop生成)
- Create run directory and scene snapshot (候选生成前的一次场景观察) 这里生成
task_analysis.md - Write K=8 candidates for iter_00 (candidate A = fix_code.py, B-H 由agent编写
.claude/libero/evosearch/skills/evosearch-iteration.md这里面有一些编写规则) - iteration eval(seed 51-65) 8候选 15trial(seeds) 看 leaderboard + 分析 traces
- (代码库缺失了)
6. Iterate:
Stopping criteria:
- Best candidate ≥ 80% on seeds 51–65
- 5 iterations completed
如果连续几轮提升很小,不要立刻结束搜索;用剩下的轮数换一些根本不同的策略继续试。
提醒搜索代理:不要只把策略调到适合 seeds 51–65;要让它也有机会适用于没见过的场景。
Per iteration:
- Update
task_analysis.md - 在第六节写排行榜
- 下一轮候选生成 用前三生成新8个
- 评估新候选
- 分析失败轨迹 阅读 analyze_evosearch_traces.py 的结果
7. Save best code, run Stage 2, write findings
- 指定获胜候选
- 比较搜索结果和基准
- 没有超过基准时回退
- 复制最终代码
Fix Loop
/fix-loop/main-agent-prompt.md
- Stage 1:由一个 actor 生成
findings.md。 - Stage 2:coordinator 在 seeds 1–50 上验证。
docs/progress/fix_loop_progress.md:汇总任务状态。subagent-prompt.md:subagent 模板。clean-task-slate.md:重跑前的清理规则。
状态设置
状态由 gen_progress.py 生成,而不是由 LLM 生成:
pending:Coordinator 分配一个 actor。stage1-done:Actor 已交付findings.md(包括fix_code.py);Coordinator 接下来运行 Stage 2 验证脚本。done:50 个 held-out seeds 的运行结果都已保存。
GPU 分配占用规则
状态包括 SUBAGENT、EVAL 和 FREE。
- 一张 GPU 同一时间只分配给一个 job。
- 任务从分配给 actor 开始,就一直占用该 GPU,直到 Stage 2 验证结束。
- 不要只看
nvidia-smi判断 GPU 是否空闲,agent 可能仍在分析。 - 恢复 coordinator 会话时,按上述规则检查并继续工作。
初始化
- 确认 server 正在运行。
Rules
- Coordinator 不亲自调试,只分配 actor、执行验证并维护 GPU。
- 分配任务后等待通知。
- Keep all 5 GPUs (3–7) occupied
- Never read task-specific debug files
- 按照状态分配工作(route by state)。
Workflow
- 先重新生成任务进度文件,再查看;不要直接相信磁盘上的旧进度表,必要时补跑。
- 根据任务状态,为空闲 GPU 分配任务。
- 派发 actor。
- Actor 完成后检查状态、运行 Stage 2 并更新 skill。
- Evaluation 完成后检查状态,包括 skill library promotion 是否成功。
更新 Skills
读取 actor 返回的 findings.md,并记录修改前后的状态:
.venv/bin/python3 scripts/libero/record_skill_promotion.py begin \
  --suite "$SUITE" --task "$TASK"

# Read findings.md and update .claude/libero/skills/*.md.

.venv/bin/python3 scripts/libero/record_skill_promotion.py finish \
  --suite "$SUITE" --task "$TASK"
新技能模式应包含:
- Trigger
- Code
- Why it works + evidence
注意事项:
- skill 中的表格只保存单行内容;过长时将流程写成小节。
- 修改已有经验时进行合并。
- skill library 只根据 seeds 51–65 更新。
Stage 2 Evaluation
给出运行命令,并提醒命名冲突问题。
/fix-loop/subagent-prompt.md
Coordinator 提供任务 suite、任务 ID、GPU ID、工作目录和 seed 范围,并说明 subagent 的角色(“what you are”)、允许和禁止使用的 API、虚拟环境,以及 test server 的运行状态。
Stage 0:探索并生成初始代码
创建 task 目录和 debug 目录:
TASK_DIR="outputs/libero_fix_loop/$SUITE/$TASK"
DEBUG_DIR="outputs/libero_fix_loop_debug"
mkdir -p "$TASK_DIR/attempts" outputs/working_codes
目录用途如下:
outputs/libero_fix_loop/:每个 task 的工作区,保存任务分析、初始程序、最终fix_code.py、调试日志、findings.md和失败 seed 记录。outputs/libero_fix_loop_debug/:保存仿真 replay 产物,通常包括每个 seed 的 trace、关键帧、运行摘要和视频,并按 suite 和 task 分类。outputs/working_codes/:保存最终fix_code.py的命名副本,方便查找和复用;正式结果也保存在对应 task 的outputs/libero_fix_loop/.../fix_code.py。
接着查看 .claude/libero/fix-loop/skills/task-exploration.md(打开 seed 51 的场景进行观察和分析)以及 .claude/libero/skills/(技能库),并保存场景图片和 task_analysis.md(包括初步假设)。
然后编写初始代码 $TASK_DIR/initial_code.py,并给出运行 seeds 51–65 的指令。
Stage 1:调试 seeds 51–65
Step 1:运行测试
- 目录名
_reward_1.000表示成功,_reward_0.000表示失败。 - 对失败的 seeds 进行 debug。
Step 2:诊断
对于失败的 seed,提供诊断所需文件:trace.json、code.py、关键帧和 summary.txt。
Step 3:编写修复代码
编写 fix_code 并重新测试。
- 如果修复失败,重新诊断并修复。
- 必要时使用
--args.interactive手动调用 API 检查环境,例如 SAM3。 - 最多尝试三次;仍未成功则跳过并记录失败。
Step 4:任务级修复
综合结果编写并保存通用 fix_code。如果都未成功,按要求给出当前最好的版本。
Step 5:编写 findings.md
Coordinator 只读取这个 findings.md:
findings.md 模板
# Findings: `$SUITE/$TASK`

## Root causes observed
<one bullet per distinct failure mode, with the seeds it affected>

## What fixed them
<the change that fixed each failure mode, with evidence: which seeds flipped to success>

## Generalizable patterns
<patterns likely to help OTHER tasks — SAM3 prompts that worked, gripper-width thresholds,
waypoint/transport tricks, drawer/knob/push techniques. For each pattern give:
- Trigger: the symptom or scene condition that calls for it
- Code: the working snippet (5–20 lines) copied from your fix_code.py, with task-specific
  prompts and constants generalized into placeholders — do not paraphrase code into prose
- Evidence: which seeds it flipped to success
- Target skill file: localize.md | grasp.md | transport.md | manipulation.md
If nothing generalizes beyond this task, write "none".>

## Blocked seeds
<seed → root cause, or "none">
执行完成后
返回以下摘要:
SUITE: <suite>
TASK: <task>
GPU: <N>

Stage 1 Results:
  Seeds passed initially: <list>
  Seeds fixed: <list of seed numbers>
  Seeds blocked: <list + root cause for each>
  fix_code.py written: yes/no
  findings.md written: yes/no

Key findings:
  <1–3 bullet points about what the failure root cause was and what fixed it>