DINO-WM: World Models on Pre-trained Visual Features enable Zero-shot Planning
Intro
预先收集的离线数据集,学习任务无关的世界模型,并在测试阶段利用该世界模型完成视觉推理与控制
测试时,系统从任意环境状态出发,并接收一张 RGB 格式的目标观测图像,输出一组动作序列 a0,…,aT,使智能体抵达目标状态
该方法不同于两类世界模型:一类是在线强化学习(RL)中使用的世界模型,其优化目标是针对一组固定任务最大化奖励;另一类是文本条件世界模型,这类模型通过文本提示词来指定任务目标
Method
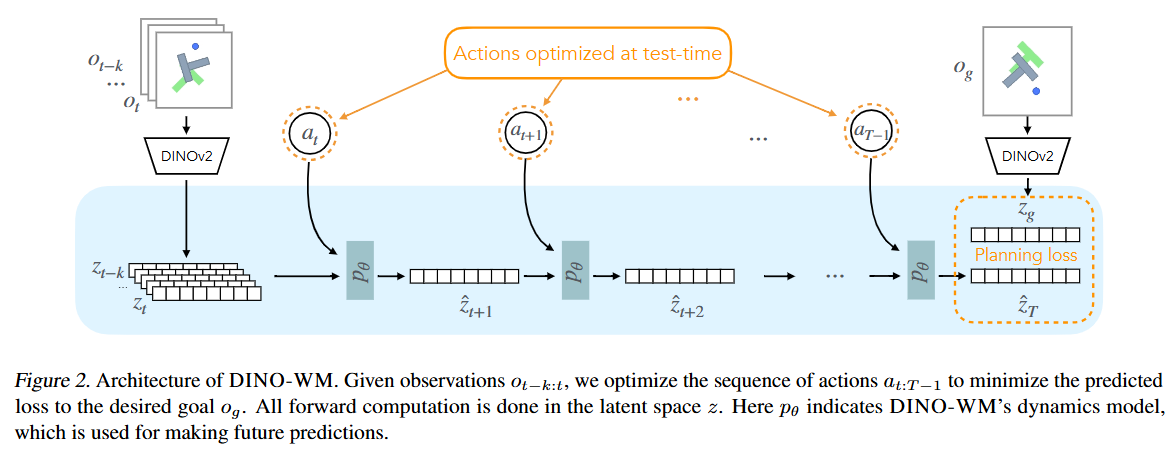
在每个时间步 t,本文的世界模型包含以下组件:
zt∼encθ(zt∣ot)
zt+1∼pθ(zt+1∣zt−H:t, at−H:t)
o^t∼qθ(ot∣zt)
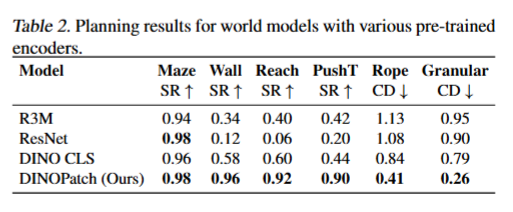
将预训练好的 DINOv2 模型用作世界模型的观测模型,利用其在目标检测、语义分割、深度估计等任务上表现出的强大空间理解能力(Oquab 等人,2024)。该观测模型在训练和测试阶段全程冻结参数。在每个时间步 t,它将图像 ot编码为图像块嵌入特征 zt∈RN×E,不只取出 class token,而是保留空间 patch。消融证明有效
选用 ViT 架构作为转移模型,并作若干修改,实现了因果注意力机制,让模型以帧为单位自回归地预测潜特征
多层感知机(MLP)对原始动作表征做映射,得到K维动作向量;再将该动作向量拼接至每一个图像块向量zti(i=1,…,N)当存在本体感知信息时,我们采用同样的方式,把本体感知信息拼接至观测潜特征,将其融合进潜状态当中
采用 teacher forcing 的方式训练世界模型。训练阶段,将轨迹切分为长度为 H+1 的片段,并对 H 个预测帧分别计算潜空间一致性损失。对每一帧,计算损失:
Lpred=pθ(encθ(ot−H:t), ϕ(at−H:t))−encθ(ot+1)22(1)
Teacher Forcing:训练时,每一步都用 "真实的历史数据" 喂给模型,而不是用模型自己上一步预测的结果。
一组转置卷积层,将图像块表征解码还原为图像像素
我们利用简单的重建损失优化解码器 qθ 的参数 θ,损失定义如下:
Lrec=∥qθ(zt)−ot∥22,其中 zt=encθ(ot)(2)
测试时,搜索一组智能体动作序列,使智能体抵达目标 og。
本文采用模型预测控制(MPC),该算法通过推演未来动作带来的结果来完成规划。
候选动作由**交叉熵方法(CEM)**随机采样并逐轮优化得到。
规划代价定义为预测得到的潜状态与目标潜状态之间的均方误差(MSE):
C=∥z^T−zg∥2
其中:
z^t=p(z^t−1,at−1),z^0=enc(o0),zg=enc(og)
DINO-WM 测试阶段优化的不是模型参数,而是动作序列:
a0,a1,…,aT−1min∥z^T−zg∥22
找一组动作,让世界模型 "想象" 出的终点尽量接近目标图像。
CEM 如何生成候选动作
候选动作不是由策略网络生成的,而是由 CEM(交叉熵方法)随机采样并逐轮优化得到。假设动作维度为 d,规划长度为 T,一条候选方案是:
A(i)=[a0(i),a1(i),…,aT−1(i)]∈RT×d
例如在二维导航中,一条候选序列可以是:
[(0.2,0.5),(0.4,0.3),(−0.1,0.6),…]
其中每个二维向量表示该时刻施加的 x,y 方向控制量。
第一批候选动作
CEM 维护一个动作序列分布:
A∼N(μ,Σ)
初始时,从预设的高斯分布中采样 N 条长度为 T 的动作序列:
A(1),A(2),…,A(N)
论文只明确说明初始分布为高斯分布,正文没有给出具体均值和方差。实际实现一般会将均值设为零动作或动作范围中点、给定较大的初始方差,并将采样结果裁剪到环境允许的动作范围。这里不需要目标策略、专家轨迹或逆动力学模型。
给候选动作打分
对每条动作序列,DINO-WM 从当前潜状态开始进行想象:
z^t+1(i)=pθ(z^t(i),at(i))
一直预测到第 T 步,再计算最终状态与目标状态的距离:
Ci=∥z^T(i)−zg∥22
距离越小,说明该候选动作序列预计越能接近目标图像。
产生下一批候选动作
选择代价最小的 K 条精英序列:
E=TopKlowest{A(1),…,A(N)}
利用这些精英序列重新估计分布:
μnew=K1A∈E∑A
Σnew=K1A∈E∑(A−μnew)(A−μnew)⊤
随后从新的、更集中的高斯分布继续采样,重复上述过程:
随机提出 100 条动作序列
        ↓
用 DINO-WM 预测各自结果
        ↓
保留最接近目标的若干条
        ↓
让新候选围绕这些优秀方案采样
        ↓
重复 10 轮
论文的计时实验采用每轮 100 条候选、10 轮 CEM 优化;这是计时设置,并不意味着所有环境都必须采用相同数量。
最后执行哪一个?
优化结束后,不会将整条动作序列全部执行完,而是只执行最优序列的前 k 个动作:
a0∗,…,ak−1∗
随后获取新的真实图像,并重新生成候选动作。这就是 MPC 的滚动规划:
观察→采样候选→预测筛选→执行少量动作→重新观察
因此,即使世界模型的长期预测存在误差,也能在每次重新观察后纠正。
DINO-WM 负责判断“执行候选动作后会发生什么”;CEM 负责提出、筛选并改进候选动作。DINO-WM 本身并不直接输出动作。
实验结果
离线世界模型在六个控制环境上的规划结果:
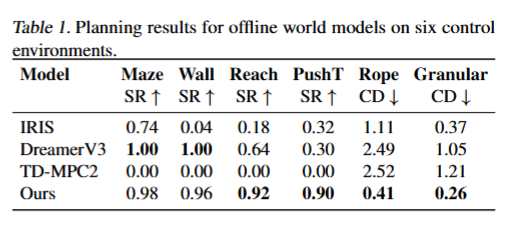
论文没有明确说 DreamerV3 与 TD-MPC2 这两个依赖强化学习奖励的模型怎么训练
可能只训练了世界模型部分,去掉了 actor-critic 再套用 MPC+CEM 生成动作?
论文中 TD-MPC2 “缺少奖励信号使TD-MPC2难以学习良好潜表示”,其规划成功率几乎为零
没有做 "ViT vs 其他转移模型架构"(比如 RNN/LSTM/MLP/CNN)的消融