Intro
世界模型会预测潜在动作带来的结果,评判家(critic)神经网络评估每个结果的价值,行动家(actor)神经网络则选择能够获得最优结果的动作
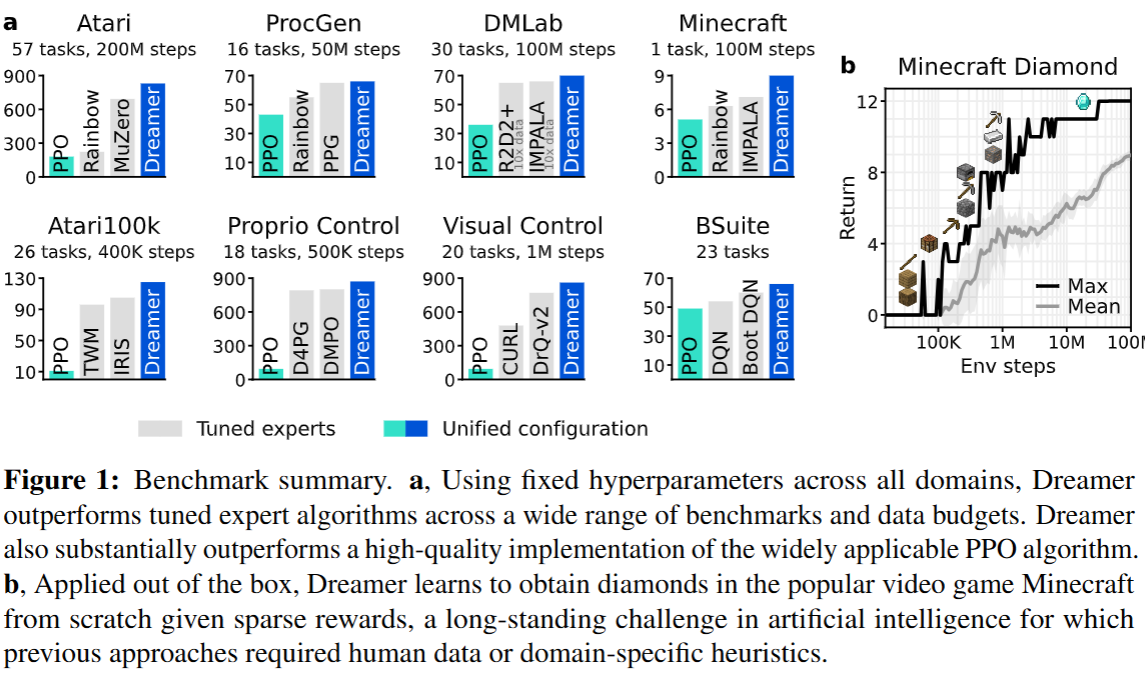
a. Dreamer 在全部任务域中使用同一套固定超参数,在大量基准测试与不同数据规模下,性能优于经过精细调参的专家算法
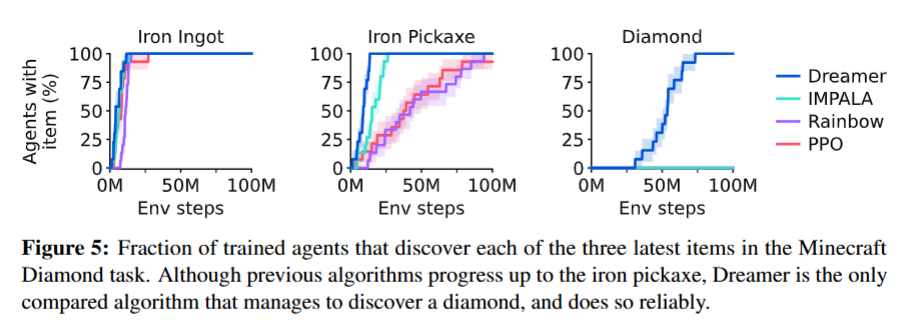
b. 无需额外定制,Dreamer 从零开始,在稀疏奖励条件下学会在知名游戏《我的世界》中获取钻石
我的世界特点: sparse rewards, exploration difficulty, long time horizons, and the
procedural diversity
提出DreamerV3,包含三个神经网络:Worldmodel预测各个潜在动作会产生的结果,critic评估每个结果的价值,actor选择动作
利用buffer同步训练
World Model
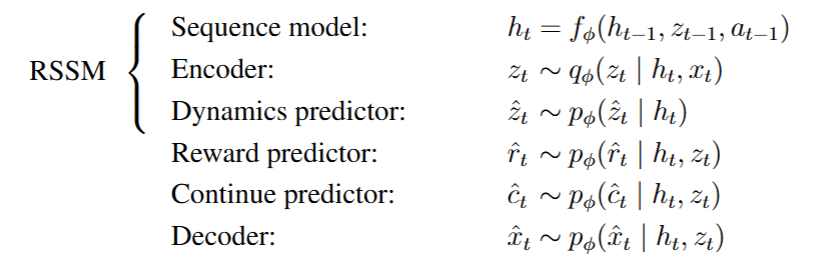
RSSM 就是 Recurrent State-Space Model,循环状态空间模型
类似:
RNN 记忆+随机 latent state
DreamerV3 里的 RSSM 核心就是这两部分:
ht
和
zt
其中 ht 是 deterministic recurrent state,负责记住过去;zt 是 stochastic state,负责表示当前环境里不确定、细节性的状态。论文把两者拼在一起作为 model state
RSSM 的一轮更新、训练时的两条状态路径,以及它们的对齐关系可以合并为:
(ht−1,zt−1)at−1ht{xtzt(ht,zt)⟶z^t≈ztposterior:编码真实观测,形成 model stateprior:模型预测,并与 posterior 对齐
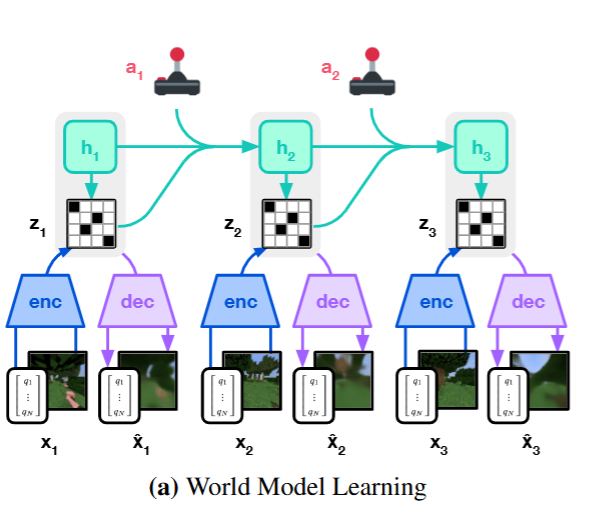
还有三个项目,注意,这里用的是真实latent
r^t∼pϕ(r^t∣ht,zt)
c^t∼pϕ(c^t∣ht,zt)
x^t∼pϕ(x^t∣ht,zt)
Loss
损失包括最小化预测损失 Lpred、动力学损失 Ldyn 与表征损失 Lrep。
L(ϕ)≜Eqϕ[t=1∑T(βpredLpred(ϕ)+βdynLdyn(ϕ)+βrepLrep(ϕ))]
1. Prediction loss
Lpred(ϕ)≜−lnpϕ(xt∣zt,ht)−lnpϕ(rt∣zt,ht)−lnpϕ(ct∣zt,ht)
Lpred:latent 里面有没有真实世界的信息?
Prediction loss 要求 (ht,zt) 保留足以重建观测 xt、预测奖励 rt 与 continue 信号 ct 的信息,因此它直接约束 latent 与真实环境有关。
若只优化 Ldyn+Lrep,q(z∣x) 和 p(z∣h) 可以都输出同一个常量,虽然此时 KL(q∥p)=0,但 z 不包含任何有用信息。Lpred 正是用来排除这种 latent collapse。
展开:没有 prediction loss 时的 latent collapse
对任意输入都输出同一个 latent:
q(z∣x)=z0,p(z∣h)=z0因此:
KL(q∥p)=0两者虽完全一致,但 z0 不携带观测、奖励或环境状态的信息。
2. Dynamics loss
Ldyn(ϕ)≜max(1,KL[sg(qϕ(zt∣ht,xt))pϕ(zt∣ht)])
Ldyn:prior 能不能追上 posterior?
这里的 sg(q) 表示 stop gradient:把 posterior q 当作固定目标,只让 prior p 去追它,而不让这项损失反过来改变 q。
式中的 max(1,KL) 称为 free bits:当 KL 已经足够小时,不再继续把它压得更低。这样 encoder 不会为了让 prior 更容易预测而丢弃观测中的细节;它仍可编码有用信息,再由 prior 根据 ht 尽量逼近 posterior。
展开:为什么需要 free bits
对两张细节不同的观测,posterior 本可编码为不同状态:
q(z∣ht,xt(1))=zt(1),q(z∣ht,xt(2))=zt(2)但 prior 只看到 ht,未必能区分这些细节。若持续强压 KL,encoder 可能把两者压成 zt(1)≈zt(2);free bits 在 KL 足够小时停止施压,避免这种信息丢失。
3. Representation loss
Lrep(ϕ)≜max(1,KL[qϕ(zt∣ht,xt)sg(pϕ(zt∣ht))])
Lrep:posterior 能不能变得更容易预测?
这里 prior 被 stop gradient 固定,因此该损失更新的是 posterior:即使它看到了真实 xt,也应避免编码只依赖当前观测、却无法由 dynamics model 从 ht 预测的细节。系数 βrep=0.1 让这种约束保持温和。
在早期实验中偶尔观察到 KL 损失出现尖峰现象,这与深度变分自编码器相关文献的报道一致。为解决该问题,将编码器与动力学预测器的分类分布参数化为1% 均匀分布与 99% 神经网络输出的混合分布。
损失尖峰:神经网络输出的分类分布,会慢慢坍缩成确定性分布:某一个类别概率趋近于 1,剩下全部类别概率≈0。
也就是模型变得极度确信,输出接近 one‑hot。
此时计算 KL 散度,会出现数值爆炸、梯度异常,KL 损失冒出尖峰,破坏训练
Critic
DreamerV3 的 critic 工作在 world model 的 latent state:
st=(ht,zt)
它不预测当前 reward,而是估计从当前状态开始的未来累计 return。critic 输出 return distribution(这里采用category distribution),value 是其期望:
vψ(Rt∣st),vt=E[vψ(⋅∣st)]
Loss
critic 同时训练 imagined 与 replay 两部分:
Lcritic=βvalLimag+βrepvalLreplay
L(ψ)=−t=1∑Tlnpψ(Rtλ∣st)
Rtλ=r^t+γc^t[(1−λ)vt+λRt+1λ]
λ=0.95γ=0.997
展开:如何理解 λ-return
可以把它读成:
λ-return=当前即时 reward+折扣后的未来价值估计r^t 是当前一步的模型预测 reward;γ 对未来回报做 discount;c^t 是 continuation flag。若 episode 在这一步结束,则 c^t=0,未来项被清零,得到 Rtλ=r^t。
方括号内是在两种未来估计之间插值:vt 是 critic 的 bootstrap value,Rt+1λ 则包含更多后续 imagined rewards。λ 越小,越早相信 critic;λ 越大,越长地沿 imagined trajectory 累积 reward:
λ=0⟹Rtλ=r^t+γc^tvtλ=1⟹Rtλ=r^t+γc^tRt+1λ因此这个 target 需要从末端向前递归计算。上式中的帽子表示 imagined trajectory 使用 world model 的预测;在 replay 路径中,将 r^t,c^t 替换为环境真实给出的 rtreal,ctreal。
终点使用 critic 的 bootstrap value:
RTλ=vT
再从后向前计算:
RTλ⟶RT−1λ⟶⋯⟶R0λ
其中 βval=1 用于 imagined trajectory,βrepval=0.3 用于含真实 rtreal 的 replay trajectory。
主要在梦里学+用真实 reward 辅助校正
从 replay buffer 中的真实状态出发,当前 actor 与 world model 滚动生成 imagined trajectory:
s0πθa0,(s0,a0)⟶s1,r^0,c^0
s1πθa1⟶s2,r^1,c^1⟶⋯⟶sT
因此得到 imagined states、actions、rewards 与 continuation flags:
s0,s1,…,sT,r^0,r^1,…,r^T−1
对于真实回放
这部分使用 rtreal(而非 world model 预测的 r^t)构造 replay 的 λ-return target,并计算 Lreplay。它的作用是当 reward predictor 不够准确时,用真实 reward 校正 critic 的 value prediction。
Rtλ 依赖 critic 自己预测的 vt,因此 target 会随 critic 改变而产生不稳定性。DreamerV3 使用 critic 参数的 EMA 版本进行正则化,作用类似 target network,使训练 target 更平稳。
Actor
- 策略网络(Actor)学习选择能够最大化回报的动作,同时依靠熵正则项entropy regularizer ( ηH(πθ(⋅∣st)) ) 完成探索
- 理想情况下,当奖励稀疏时(H主导),我们希望智能体多做探索;当奖励密集或者奖励就在眼前时(策略梯度主导),则更多利用已有经验(通过ηH(πθ(⋅∣st)))
- 探索的程度不应受环境奖励的任意缩放所影响。这就需要对回报的量级做归一化(S),同时保留奖励出现频率的相关信息。
Loss
L(θ)=−t=1∑Tsg(max(1,S)Rtλ−vψ(st))logπθ(at∣st)+ηH(πθ(⋅∣st))
本质策略梯度 + 正则
优势函数 At=Rtλ−vψ(st)
return scale 用 5% 到 95% 分位数的范围,保证策略梯度和熵的尺度保持相对一致,同时避免极端值的干扰
S=EMA(Per95(Rλ)−Per5(Rλ))
鼓励explore
ηH(πθ(⋅∣st))
H(π(⋅∣s))=−i=1∑Kpilogpi
η=3×10⁻⁴
前面要做 return normalization,就是为了这个 entropy scale 能跨环境固定使用
于是优化器会主动修改 θ,让 H 变大,也就是将分布朝均匀的方向推动,因此鼓励探索
Robust prediction
DreamerV3 希望用一套固定超参数跨任务训练,但不同环境中的 observation、reward 与 return 的数值范围可能相差多个数量级。直接使用普通回归会让大数值 target 主导梯度,训练容易不稳定。
普通 MSE 的形式为:
LMSE=21(y^−y)2,∂y^∂LMSE=y^−y
因此当 y 很大而预测仍接近零时,梯度也会很大。DreamerV3 的 Robust prediction 用两条路径处理不同类型的 target:
vector / deterministic targetsreward / return (stochastic)⟶symlog squared error⟶symexp two-hot loss
1. symlog squared error:压缩连续确定性目标
这条路径主要用于 vector observations 等连续且相对确定的 target。这里需要区分输入模态:
- Images:使用卷积编码器提取特征;decoder 使用转置卷积重建图像,并在输出端使用 sigmoid。图像不会先做 symlog。
- Vector inputs:才会使用 symlog;对应的 decoder target 也在 symlog 空间中进行预测。
作用于 World Model Loss
Lpred=−lnpϕ(xt∣zt,ht)−lnpϕ(rt∣zt,ht)−lnpϕ(ct∣zt,ht)
的
−lnpϕ(xt∣zt,ht)
symlog 保留正负号,同时压缩大绝对值:
symlog(x)=sign(x)ln(1+∣x∣)
其逆变换为:
symexp(x)=sign(x)(e∣x∣−1)
例如,大数值会被压缩到温和范围:
100000⟶symlog(100000)≈11.5,−100000⟶−11.5
而在零附近,symlog(x)≈x,因此不会明显扭曲本来就很小的数值。网络不直接回归 y,而是回归其 symlog 值:
fθ(x)≈symlog(y)
Lsymlog=21(fθ(x)−symlog(y))2
需要原始尺度的预测时,再使用:
y^=symexp(fθ(x))
2. symexp two-hot loss:处理 reward 与 return
用于 reward predictor 与 critic 的 Loss
即
−lnpϕ(rt∣zt,ht)
and
L(ψ)=−t=1∑Tlnpψ(Rtλ∣st)
reward 与 return 可能是随机的:同一状态的未来回报可能有多个合理结果(如 0和100)。若直接回归单一标量,模型容易学到不一定真实出现过的平均值(50);因此 reward predictor 与 critic 改为预测一个 distribution。
网络先在 symlog 空间均匀设置 bins [−80,−60,−40…,20,40,…],再通过 symexp 映射回原始数值空间:
ui=−20+K−140(i−1),bi=symexp(ui),i=1,…,K
这会让 bins 在零附近更密、绝对值较大时更稀疏,因而能够覆盖宽广的 return 范围。训练时使用 two-hot cross entropy;梯度主要取决于模型是否将概率分配给正确 bins,而不直接随 target 数值大小增长。
Category Distribution
定义一组离散 return bins。给定状态 st,critic/reward predictor 网络输出 logits,经 softmax 得到各 bin 的概率,也就是 return distribution:
vψ(Rt∣st)=Cat(p1,p2,…,pK)
其中:
pi=P(Rt=bi∣st)
虽然 bins 是离散的,最终的 value 仍可取连续值,因为使用各 bin 的概率加权平均:
R^t=i=1∑Kpibi=softmax(fψ(st))TB
例如,若相邻 bins 为 bk=10、bk+1=20,概率为 pk=0.7、pk+1=0.3,则预测为 0.7×10+0.3×20=13。
将 return 转换成 two-hot 标签
若 target Rtλ 落在相邻 bins bk 与 bk+1 之间,则只有这两个 bin 的标签非零,且权重按距离线性插值:
twohot(Rtλ)k=bk+1−bkbk+1−Rtλ,twohot(Rtλ)k+1=bk+1−bkRtλ−bk
因此论文中的负对数似然:
−logpψ(Rtλ∣st)
在 categorical 实现中等价于:
−i=1∑Ktwohot(Rtλ)ilogpi
展开为:
L=−bk+1−bkbk+1−Rtλlogpk−bk+1−bkRtλ−bklogpk+1
Result
Benchmark
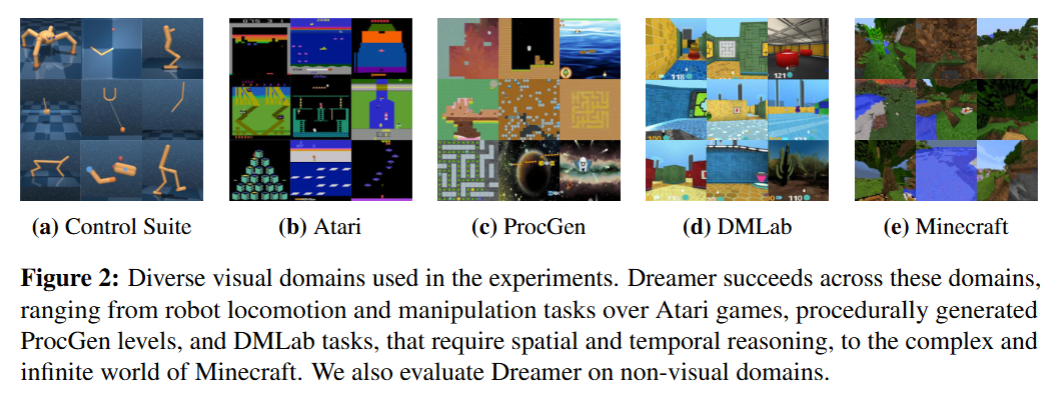
开展了大规模实证研究,覆盖 8 个任务域,包含连续与离散动作、图像与低维输入、稠密与稀疏奖励、不同奖励量级、二维与三维虚拟世界,以及程序生成式任务
Minecraft
在热门游戏《我的世界》中采集钻石,回合会持续到玩家死亡,或是最多运行 36000 步 (30min)
在此期间,智能体需要搜集资源、制作工具,在稀疏奖励条件下依次获取 12 种物品。熟练的人类玩家拿到钻石大约需要 20 分钟
直接使用 Dreamer 的默认超参数开箱即用,成为唯一能找到钻石的算法
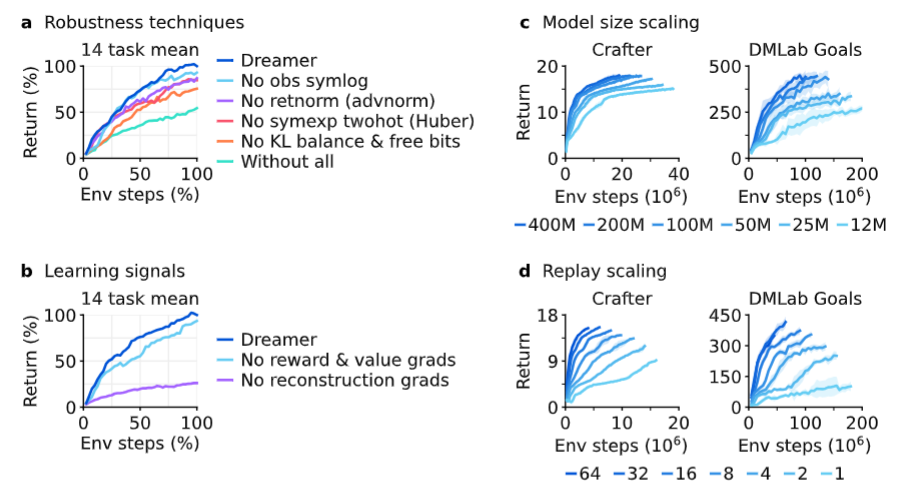
消融实验证明,全部鲁棒性技术都对最终性能存在贡献;其中世界模型的 KL 目标作用最为显著
总体来看,每一项技术都会在一部分任务上起到关键作用,但在另一些任务上可能对性能几乎没有影响
具备稳健的规模扩展能力,在 Crafter 与一项 DMLab 任务 上训练 6 种不同模型规模
在不同模型规模、回放比下都能稳健学习
Appendix
Minecraft diamond-env:观测空间与动作空间
DreamerV3 使用的是基于 MineRL 改造的 diamond-env,而不是人类直接以键盘、鼠标操作的原版 Minecraft。论文中的 block-breaking setting 指环境已将部分复杂交互封装为高层离散动作。
Episode
- 一回合从角色出生开始,在角色死亡或达到最大 36,000 步时结束,约为 30 分钟游戏时间。
- 共有 12 个稀疏奖励里程碑:原木、木板、木棍、工作台、木镐、圆石、熔炉、石镐、铁矿、铁锭、铁镐、钻石。
- 每种里程碑物品在一个 episode 中首次获得时奖励 +1,理论最高累计奖励为 12;生命变化另有很小的 ±0.01 奖励或惩罚。
观测空间
严格来说,环境提供给 agent 的是 observation xt,而不是完整的 Markov state。论文第 22 页给出的多模态 observation 为:
xt={It,inventoryt,milestone-historyt,equipped-itemt,healtht,hungert,breatht}
- POV 图像:第一人称的
64 × 64 × 3 RGB 截图。
- Inventory count vector:400 多种游戏物品的数量计数向量。
- Milestone history:从 episode 开始以来各物品的最大持有数量,用于提供已完成 milestone 的历史信息。
- Equipped item:当前装备物品的 one-hot 向量。
- 标量信息:health、hunger 与 breath。
论文列出的 observation 字段不含真实世界坐标 (x,y,z)。DreamerV3 将图像通过 CNN encoder 编码、将向量输入经 symlog 后通过 MLP encoder 编码,并写入 RSSM 的 latent model state:
st=(ht,zt)
因此应区分环境 observation xt 与 Dreamer 内部的 latent state st。
动作空间:flat categorical action space
论文将 MineRL 环境重构为 flat categorical action space:actor 在单一离散动作集合中选择一个类别,而不是直接输出一组原始键鼠控制量:
at∈{1,2,…,K}
πθ(at∣st)=Categorical(p1,…,pK),at∼πθ(⋅∣st)
MineRL v0.4.4 提供 abstract crafting actions,因此 crafting 不要求 agent 在 GUI 中逐步操作。Minecraft 的 jump 需要持续按键才会生效,环境层将 jump 实现为后台持续按住 200ms。
论文没有在这一页完整列出 K 个动作类别及其逐项定义,因此不应仅凭论文把动作集合的每一个具体动作写死。可以确定的是:这里是高层离散抽象动作空间,DreamerV3 的 actor 使用离散动作的 REINFORCE 梯度。
MDP 总结
OSARTγ:RGB、inventory、milestone history、equipped item、health/hunger/breath:st=(ht,zt),由 Dreamer 根据 xt 构造的 latent state:flat categorical 的高层离散动作集合:12 个里程碑首次获得各 +1,以及生命变化的 ±0.01:死亡或 36,000 步:0.997
常见误区
- AI 不是以原版 Minecraft 的键鼠原语操作,而是在抽象后的
diamond-env 中行动。
- DreamerV3 算法本身不定义观测和动作;它们由
diamond-env 环境提供。
- 向量观测会在 DreamerV3 内部经过 symlog 预处理,但观测数据本身仍由环境产生。
- 论文明确给出的是 flat categorical action space、abstract crafting actions 与 jump 的 200 ms 按住机制;并未在该页列出全部具体动作类别。
与原版 MineRLObtainDiamond 相比,diamond-env 使用 flat categorical 动作与 abstract crafting actions,将部分复杂交互从键鼠原语层面抽象出来,从而降低动作空间的探索难度。
DreamerV3 模块架构总览
| 模块 | 输入 | 输出 | 论文中的架构 | 作用 |
|---|
| Image Encoder | 图像 xt | observation feature,供 posterior 推断 zt | stride-2 CNN;最后压缩到 6×6 或 4×4 后 flatten | 图像编码 |
| Vector Encoder | inventory、health 等 vector | feature | symlog + 3-layer MLP | 编码结构化状态 |
| RSSM Sequence Model | ht−1,zt−1,at−1 | ht | GRU;block-diagonal recurrent weights,8 blocks | 维护历史与动力学记忆 |
| Encoder / Posterior | ht,xt | qϕ(zt∣ht,xt) | categorical latent distribution | 从真实观测推断 latent |
| Dynamics Predictor / Prior | ht | pϕ(zt∣ht) | MLP + categorical distribution | 预测 latent dynamics |
| Image Decoder | ht,zt | x^t | transposed stride-2 CNN + sigmoid | 重建图像 |
| Reward Predictor | ht,zt | pϕ(rt∣ht,zt) | 1-layer MLP | 预测 reward distribution |
| Continue Predictor | ht,zt | pϕ(ct∣ht,zt) | 1-layer MLP | 预测 episode 是否继续 |
| Actor | st=(ht,zt) | πθ(at∣st) | 3-layer MLP | 选择动作 |
| Critic | st=(ht,zt) | return distribution | 3-layer MLP | 预测长期价值 |