World Action Models are Zero-shot Policies
World Action Models are Zero-shot Policies
基于预训练视频扩散主干网络构建的世界动作模型(WAM)
这是一类以对齐方式同时预测动作与未来视觉状态的基础模型
架构分析表明:规模更大的预训练视频扩散模型能够生成质量更高的视频预测结果,而这会直接带来下游动作执行效果的提升 —— 这说明策略性能从根本上与视频生成质量紧密相关。这个发现和WM的主流观点相悖
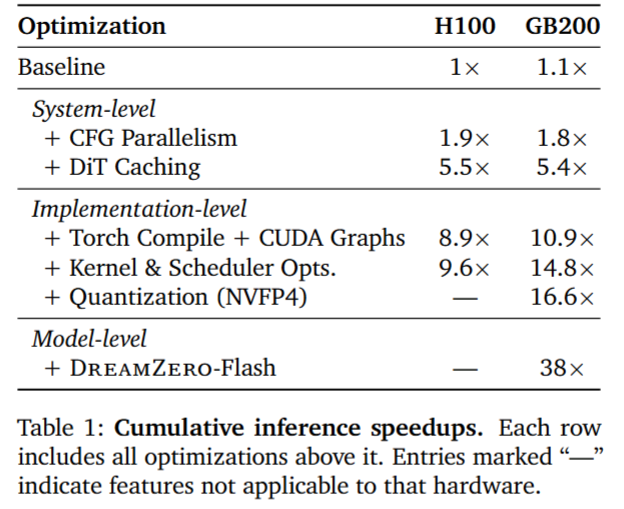
引入了三大优化方案做推理加速
挑战以及解决方式
1. 视频-动作 对齐
联合预测视频与动作,要求未来视觉画面和电机指令紧密耦合
但如果简单地拼接相互独立的视频输出头与动作输出头,就会出现模态失配问题
训练单个端到端模型,共享一个损失目标对视频和动作进行联合去噪
2. Architectural design
双向架构 vs 自回归架构
自回归架构
每执行完一个动作块之后,用真实观测数据替换 KV 缓存内的模型预测帧,以此消除误差累积
KV 缓存实现高效推理
3. Real-time Inference
视频扩散模型需要在高维隐空间中执行迭代去噪运算
推理速度慢无法满足闭环控制的实时要求
推出一套涵盖系统层、实现层以及模型层的优化方案,实现38 倍推理加速,支持 7 赫兹的实时控制
模型架构
Model Architecture
分为两个部分
其中 语言指令 、本体感知状态 ,以及包含当前帧与历史时序的视觉观测 为条件,联合预测未来视频序列 与动作序列
本文没有采用两个独立模型(视频预测模型与逆动力学模型)去拟合分解后的训练目标,而是以 联合预测目标 对单个模型开展端到端训练
并认为这会比 VLM 微调得到的 VLA 泛化更强,因为可以从视频帧中显式学习时序动力学,而这些视频帧 既是模型的条件输入,同时也是预测目标
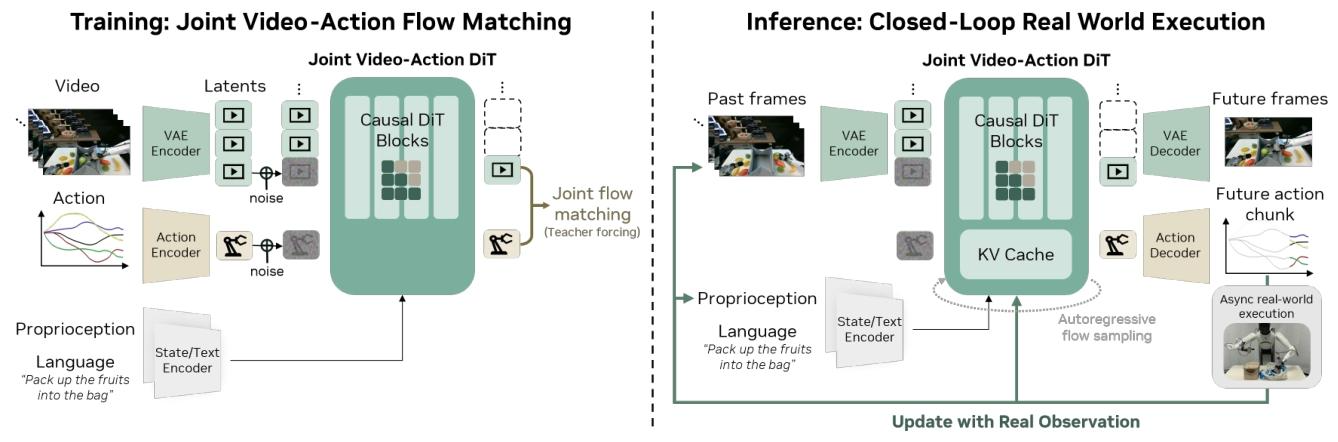
架构如图
新增少量参数模块:
- 本体状态编码器 state encoder
- 动作编码器 action encoder
- 解码器 action decoder
将所有视角画面拼接为单帧图像,而不对主干模型本身的架构进行修改
以自回归方式训练,优势:
- KV-cache
- 策略模型能用历史视觉观测 ,指导后续生成
- 规避双向模型模态(视频 动作 语言)对齐问题
Appendix B
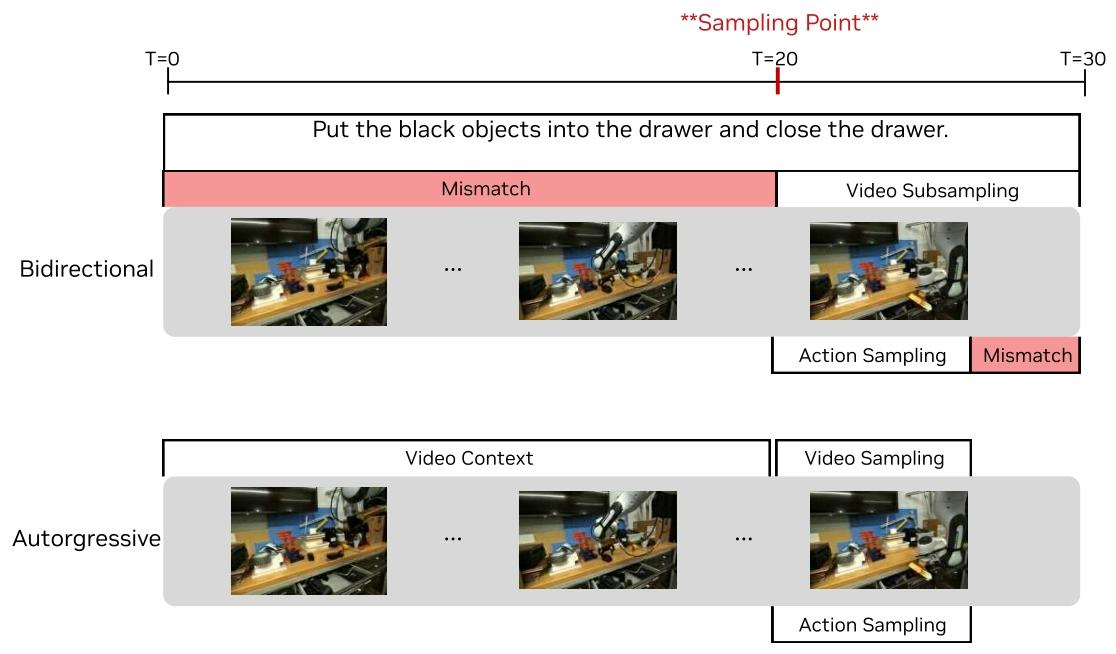
双向扩散一次只能生成一个固定长度的片段,若未来需要帧数超过,需要抽帧降采样,帧率被扭曲,多模态信息错位,提高对齐学习难度
DreamZero 采用分块的方式训练预测视频帧;每个块包含固定数量的隐帧 K,与动作预测时域相匹配。分块生成的方式支持使用可变长度视频开展训练,原理类似于大语言模型基于可变长度词元进行训练
QKV 自注意力掩码
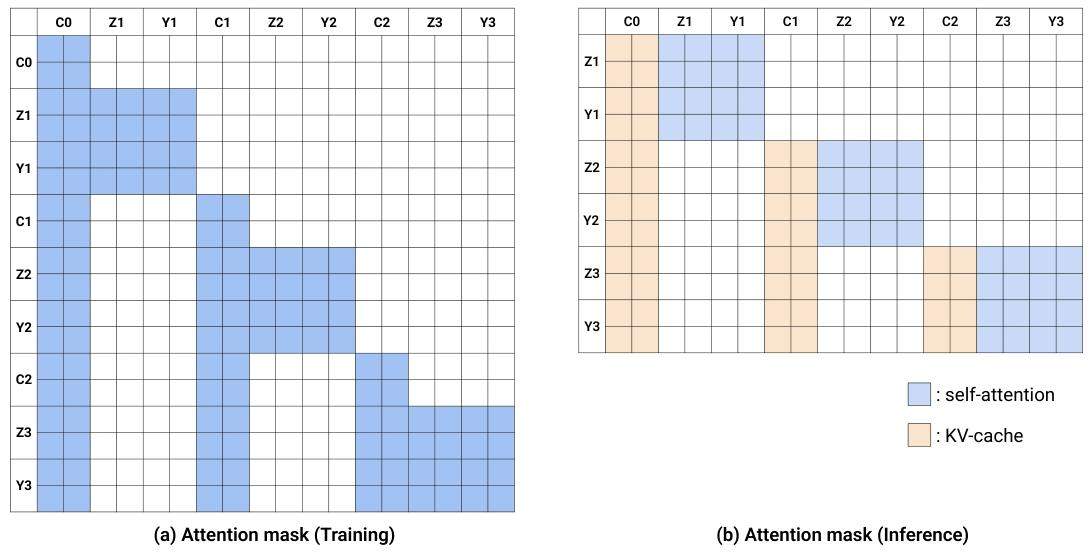
:机器人不同时刻的真实观测画面,作为条件 Context。 :模型要生成的未来视频 latent。 :模型要生成的机器人动作。 纵轴是 Query,横轴是 Key/Value。
Training Objective
flow‑matching 作为训练目标
DreamZero 在视频模态与动作模态之间共享去噪时间步,以此加快训练初期的收敛速度
将teacher‑forcing纳入训练目标;模型以干净的历史时序块为条件,对当前带噪声的时序块执行去噪学习。
模型对 和 执行去噪;二者定义为干净向量与随机高斯噪声之间的线性插值:
其中 , ,、 分别为视频隐向量与归一化动作。
由此,来自前面所有时序块的干净上下文可记为:
损失
其中 ,为不同噪声等级的损失权重
这里的问题是 视频和动作的维数相差可能极大 视频容易完全盖过动作 导致动作难以学习
论文里面没有具体讲解
Model Inference
KV 缓存 真实观测帧替换 KV 缓存中模型生成的帧
Real-time Execution
问题
- 16步去噪
- 140亿 DiT
- 串行推理
方案
1. 异步推理
一边执行动作,利用执行动作的时间不断接受新观测 + 预测
2. 系统层面
有条件前向传播与无条件前向传播 放在两块gpu
相邻两次预测速度之间的余弦相似度超过阈值时,复用缓存的速度值 执行步数可以减小 平均16 -> 4 步
3. 工程实现
Torch‑Compile + CUDA‑Graphs
量化
- 绝大多数权重、激活 NVFP4
- 敏感危险运算(QKV Softmax Attn) FP8
- 非线性激活层 FP16
内核与调度器优化
- cuDNN 后端(高性能加速库)做注意力计算
- 调度器运算迁移至 GPU 解决 CPU‑GPU 同步阻塞
Flash 版本
减小去噪时间步
要求模型在视频仍带有部分噪声的条件下,输出干净无噪的动作
训练的时候,主动给模型喂大量 视频噪声高 但动作干净样本 提前适应
Beta 分布 ,随机变量
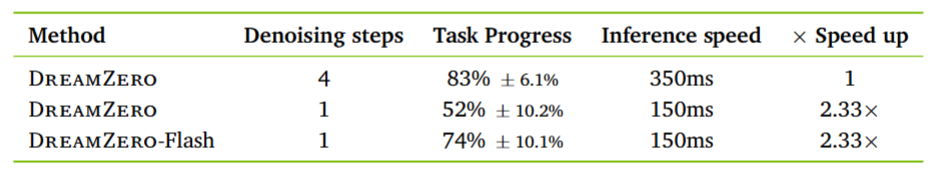
该设置让模型接触到大量从带噪声的视觉上下文预测干净动作的样本场景,直接匹配少步数、单步推理的运行模式。最终扩散采样步数可以由 4 步降至 1 步,推理耗时由约 350 毫秒缩短至约 150 毫秒,性能损失很小
Action Chunk Smoothing
上采样 2 倍 -> Savitzky‑Golay 滤波 -> 下采样回到原来长度
累计推理加速效果。每一行都包含其上所有行列出的全部优化项
Experiment
选两个 VLA 基线 GR00T N1.6 and
评估两种初始化方案 : (1) 从零开始初始化:仅加载预训练视觉语言模型(VLM)权重,不使用任何先前的机器人数据进行训练,以此和 DreamZero 开展公平的对照实验;
(2) 预训练权重初始化:使用官方发布的检查点,该权重已在数千小时跨机器人本体数据集上完成预训练
后续均采用与 DreamZero 完全相同的数据开展训练
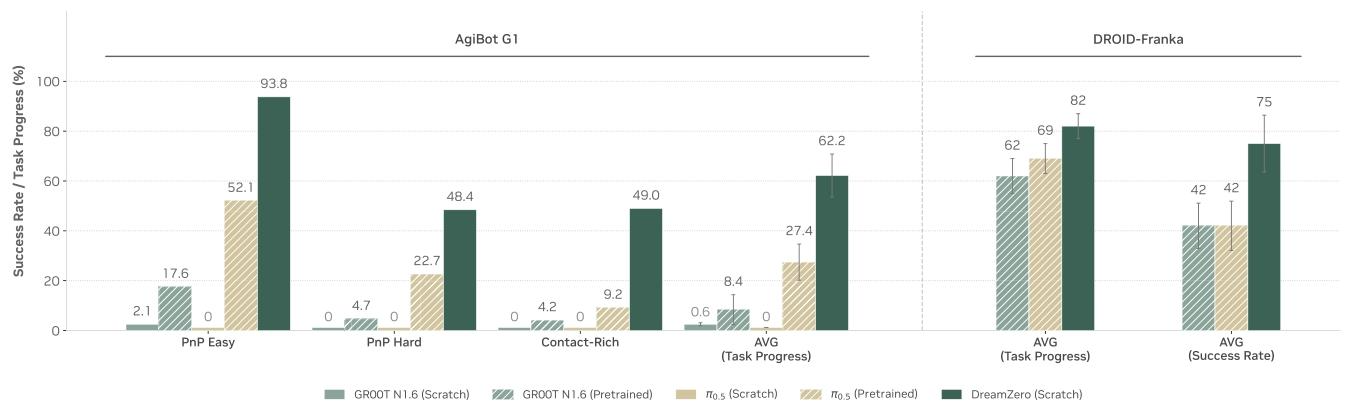
AgiBot 真机评测是人打分,仿真 DROID 自动打分