World‑in‑World: World Models in a Closed‑Loop World
https://world-in-world.github.io/
ICLR 2026 Oral Presentation
首个面向具身智能的 闭环 世界模型 测评开源平台
核心观点:视频生成的画质不等于世界模型在具身任务上面的性能;可控性,后训练数据规模,推理时计算资源对任务成功更加关键
Introduction
现有测评系统侧重衡量视频生成质量/视觉合理性,但目前还没有任何基准能够检验:生成出的虚拟世界是否真的能够提升具身推理能力与任务表现
比如,能否帮助智能体感知环境,规划执行动作,获取观测结果,再次规划执行
具体而言,文章提出一套闭环在线规划的统一策略以及标准化动作 API(标准化动作 API 对不同世界模型所要求的输入模态进行统一适配),能够将各类不同的世界模型无缝接入闭环任务。此外,设计了一套后训练流程:使用取自下游任务相同动作空间的少量动作‑观测数据,对预训练视频生成模型进行微调。
统一的闭环策略
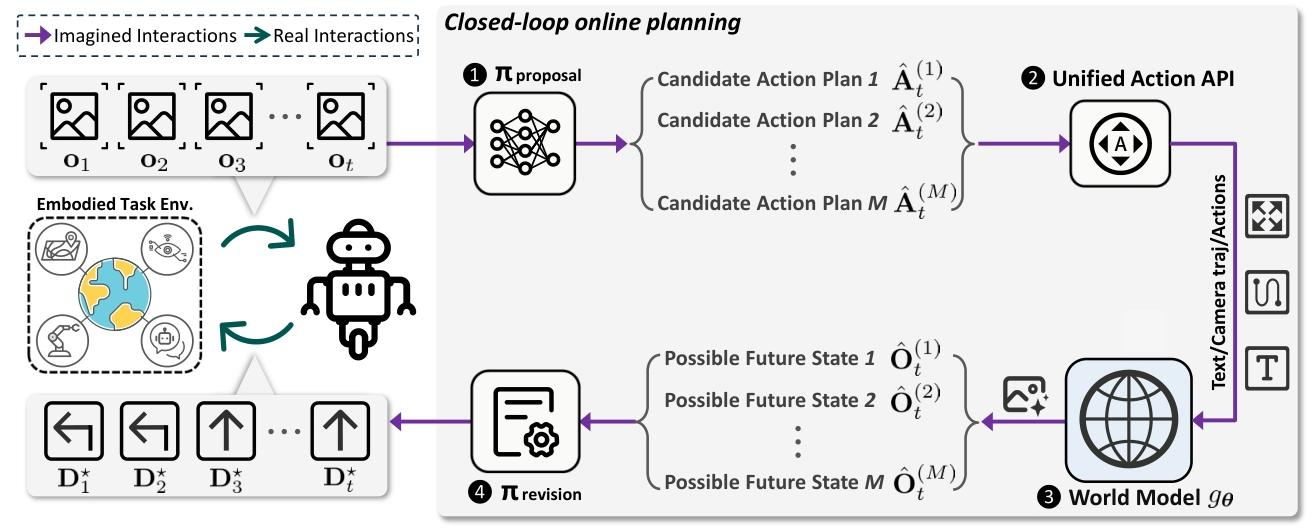
该策略循环执行提议、仿真、修正三个阶段。在提议阶段,智能体生成若干候选规划方案
提议阶段:生成若干候选规划方案
仿真阶段:世界模型做推演
修正阶段:智能体打分,并且优化规划方案
最后执行得分最高的规划
任务类型
| 任务 | Proposal policy | Revision policy |
|---|---|---|
| Active Recognition | Qwen2.5-VL-72B 或 heuristic | 默认 Qwen2.5-VL-72B |
| ImageNav | Qwen2.5-VL-72B 或 heuristic | 默认 Qwen2.5-VL-72B |
| A-EQA | Qwen2.5-VL-72B | 默认 Qwen2.5-VL-72B |
| Manipulation | Qwen2.5-VL-72B 或 3D Diffuser Actor | 默认 Qwen2.5-VL-72B |
heuristic:从 primitive action space 里采样候选动作,但加两条人为规则约束(不能执行上一步的反向动作+同一个方向最多连续转弯四次)
3D Diffuser Actor:一个学习出来的机器人动作生成模型,而且用的是 diffusion 思想
流程详解
代表智能体在时间 的自中心观测(即第一人称观测)
为候选动作序列
用于提出策略
用于评估修改,选出最优方案,得到决策
首先,输入观测+目标
然后,经过API统一
其中 的形式取决于所选世界模型的输入格式,可以包含文本提示词、相机轨迹或者底层动作序列。
接着世界模型推演
最后打分选择
不一定直接原样挑选某一条候选,也可以综合全部候选集合及其预测结果,融合信息生成、更新一份全新决策。
最优决策 在真实环境执行完毕后,智能体在时间步 获取新的观测。该统一策略重新进入提议‑仿真‑修正循环,利用新观测状态开启下一轮的提议、仿真与修正流程。
和 均可灵活实例化
API 统一动作
把候选动作转换成世界模型需要的输入(提示词)
- 文本提示词:通过预定义模板把每一个基础动作转换为短语,拼接全部短语后得到最终文本
- 相机轨迹 / 观测视角:类似
I_traj = [(x_1, y_1, φ_1), (x_2, y_2, φ_2), ..., (x_K, y_K, φ_K)] - 底层动作
综合性具身任务
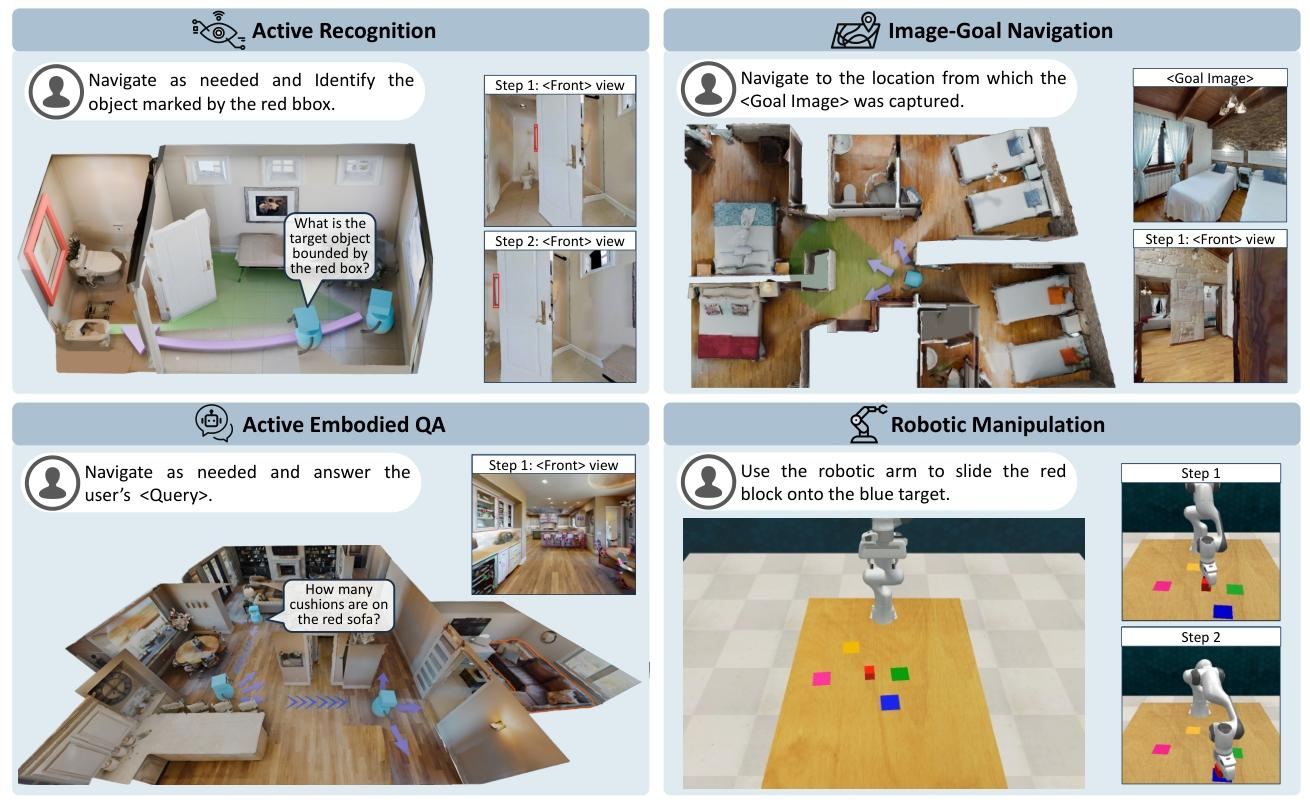
主动识别
目标物体要么处于极端观测视角下,要么被严重遮挡。这类设定迫使智能体必须主动对环境进行探索,并且依靠世界模型做出有理有据的决策
任务设置
设定 K=10 时间步,接收观测
- 预测类别:模型生成合成的未来视图,作为真实观测 之外的辅助证据
- 确定下一步动作:规划器每一步会生成 条候选动作序列,每条序列的规划视界
当达到步数上限 ,或者预测类别的置信度超过 95% 时,当前任务片段结束。
真实帧的真值红色包围盒作为种子提示,喂给 SAM2 分割模型,让 SAM2 在世界模型生成的虚拟预测图片里,追踪分割出同一个目标物体,手动在虚拟帧上画出红色包围盒。
实现细节:VLM 分类与置信度获取
AR 不直接让 VLM 输出类别名,而是在 prompt 中临时编号候选类别,例如 004. chair,并要求只输出编号。编号仅在当前 prompt 中表示该类别;004 本身没有固定语义。
图像(含红框)+ 任务说明 + 候选类别编号 + 输出格式
    → VLM 在输出位置计算整个词表的 token 概率
    → API 返回 top-k token 的 logprob
    → 筛选合法编号,映射回类别
    → exp(logprob) 作为 Confidence
关键前提:OpenAI vocabulary only supports 000-999 as a single token, 4-digit text will be splitted
若模型在类别位置输出 004,且 logprob("004") = -0.094,则 exp(-0.094) ≈ 0.91;显示的 chair: 91% 表示模型在该条件下生成编号 004 的 token 概率约为 91%。它不是专门分类头输出的、经校准的真实类别概率,也不是模型额外给出的自我评价。
使用编号可减少类别名的拼写、大小写、多词类别及解析格式问题,并便于固定位置读取 logprob。该方案是 zero-shot:依靠原始 VLM、图像和类别列表 prompt,无需另加分类头、LoRA 或标注数据后训练。注意编号未必对所有 tokenizer 都是单个 token;本地模型若不遵循格式,代码会重试,最终可能退化为随机选择。
导航
主动具身问答(A‑EQA)
机器人操纵任务
后训练实现方案
基于两套仿真环境 Habitat‑Sim 和 CoppeliaSim 的数据开展微调,以适配各自对应的任务领域。
针对 Habitat‑Sim 下的任务(主动识别 AR、主动具身问答 A‑EQA、图像目标导航 ImageNav),我们采用取自 HM3D(Ramakrishnan 等人,2021)训练集划分的全景动作‑观测数据集进行后训练。针对 CoppeliaSim 的机器人操纵任务,则使用 RLBench(James 等人,2020)生成的任务演示数据完成后训练
这里的 HM3D 是3D场景数据集 只有环境几何 但是划分了训练集和验证集场景,需要自己采样路点、做测地距离计算、贪心剪枝、规划行走路径
RLBench是机器人操控的仿真基准环境,内置运动规划器,可以直接批量生成专家轨迹
首先对学习目标以及动作‑观测对齐做形式化定义(附录 C.1),随后详细介绍 Habitat‑Sim 各项任务与机器人操纵任务所使用的具体后训练实验配置(附录 C.2)
形式化定义
导航任务
导航里,动作是相对变化
这里补充一个 做对齐
| frame | action condition |
|---|---|
| Forward | |
| TurnLeft | |
| Forward | |
Manipulation
它记录的是机械臂在每一时刻的绝对末端位姿
即 三个三维坐标 + 三个欧拉角 + 夹爪开合状态,不需要补充
后训练配置
这里只训练视频生成模型(世界模型),完全不训练策略网络
不学习做任务(识别 / 导航 / 问答),只学习「动作 → 画面变化」这个视觉动力学,所以说是只训练世界模型本身,而非具体到下游任务
针对 Habitat‑Sim 平台下的任务,用全景观测图像576 × 1024分辨率,对生成模型微调,基于在 Habitat‑Sim 环境中自行采集的全景动作‑观测数据集,训练模型预测后续N帧画面。该类任务采用离散动作空间,包含 4 种导航基础动作:前进 0.2 米、左转 22.5°、右转 22.5°、停止。
针对机器人操纵任务,视频生成模型的输入、输出均使用前视观测图像。以连续 7 自由度末端执行器位姿作为条件输入,训练模型预测N帧未来画面。
后训练数据集构建
针对操纵任务使用的后训练数据集,我们直接使用 RLBench 官方代码生成数据。具体来说:每个操纵任务生成 200 条专家演示轨迹;每条演示大约包含 150 张前视 RGB 图像,以及对应的 7‑DoF 末端执行器位姿序列。这些位姿序列和图像完成时间对齐,在后训练的时候充当动作标签。
对于 Habitat‑Sim 上评估的任务,在HM3D、Matterport3D 的训练集室内场景中采样动作轨迹,构建一套完整的后训练数据集
| Statistic | Value |
|---|---|
| Number of scenes | 858 |
| Panorama RGB frames | 763,724 |
| Action trajectories | 439,213 |
| Depth recorded | ✓ |
| Camera poses recorded | ✓ |
| Low-level actions recorded | ✓ |
构建核心要求:
- Diversity 多样性: 覆盖大量视角动作
- Plausibility 合理性:遵循物理规律
- Manageability 可控性:避免冗余重复
World-in-World 没有规定一个统一的 post-training loss,而是沿用各个视频生成模型的官方微调方法
流程
1. 路点选择 Waypoint selection
设房间可通行面积S,路点密度
在房间可通行区域均匀采样得到候选点集合P。
构建完全图(每两个点之间都连一条边),边权重为两点之间测地距离(机器人地面行走距离,不是直线欧氏距离)。
每个点 计算叶节点得分 leaf‑score:
越高,代表点越靠近房间外围(墙角、房间边缘)
把全部候选点集合 ,从大到小(降序)排,做贪心半径剪枝()
-
初始化最终集合
-
取出当前点
-
检查: 和 里面已经选中的每一个点的测地距离,是不是全部
-
是:把 加入
否: 直接丢掉这个点
2. 路径生成 Path generation
维护未访问路点集合 ,初始取 中得分最高的 个外围点。
从 随机取起点 ,循环执行:
- 在未访问点集合 中,寻找与当前点测地距离 最近 的点 (点间距离过远,会导致生成的路径一次抹除过多未采集路点)
- 调用 Habitat 内置路径规划器,求解无碰撞最短路径 。
- 沿路径 的每一步记录全景 RGB-D 帧,存入轨迹集合 。
计算底层依赖 Habitat‑Sim 的NavMesh 导航网格:仿真预先对场景 mesh 生成可通行多边形网格,pathfinder 在 NavMesh 上做寻路得到 collision‑free 最短路径
这里
它可以由多个路径点组成,例如
但是中间的:
不是 里的 waypoint,它们只是 Habitat 为了描述这条几何最短路径而产生的中间路径点/拐点。
3. 路点动态更新 Waypoint dynamic update
走完一段路径 后:
- 只要某路点 与路径上任意一点 的测地距离小于 ,就把该路点标记为已访问,并从集合 移除。
- 在剩余路点上重新计算全部 leaf-score、重新排序,刷新未访问集合 。
- 把本次终点 作为下一段路径起点,回到 Path generation,循环直到 为空。(也就是这里不再需要从 采集起点了,只负责从里面找到距离起点最近的一个终点 )
动态重新计算得分的意义是:优先采样房间边缘区域,避免反复在走廊中间采集大量高度重复画面。
最后我们返回 因此可以写成:
而一条轨迹内部,真正有用的是按时间排列的 action-observation 数据,例如:
伪代码
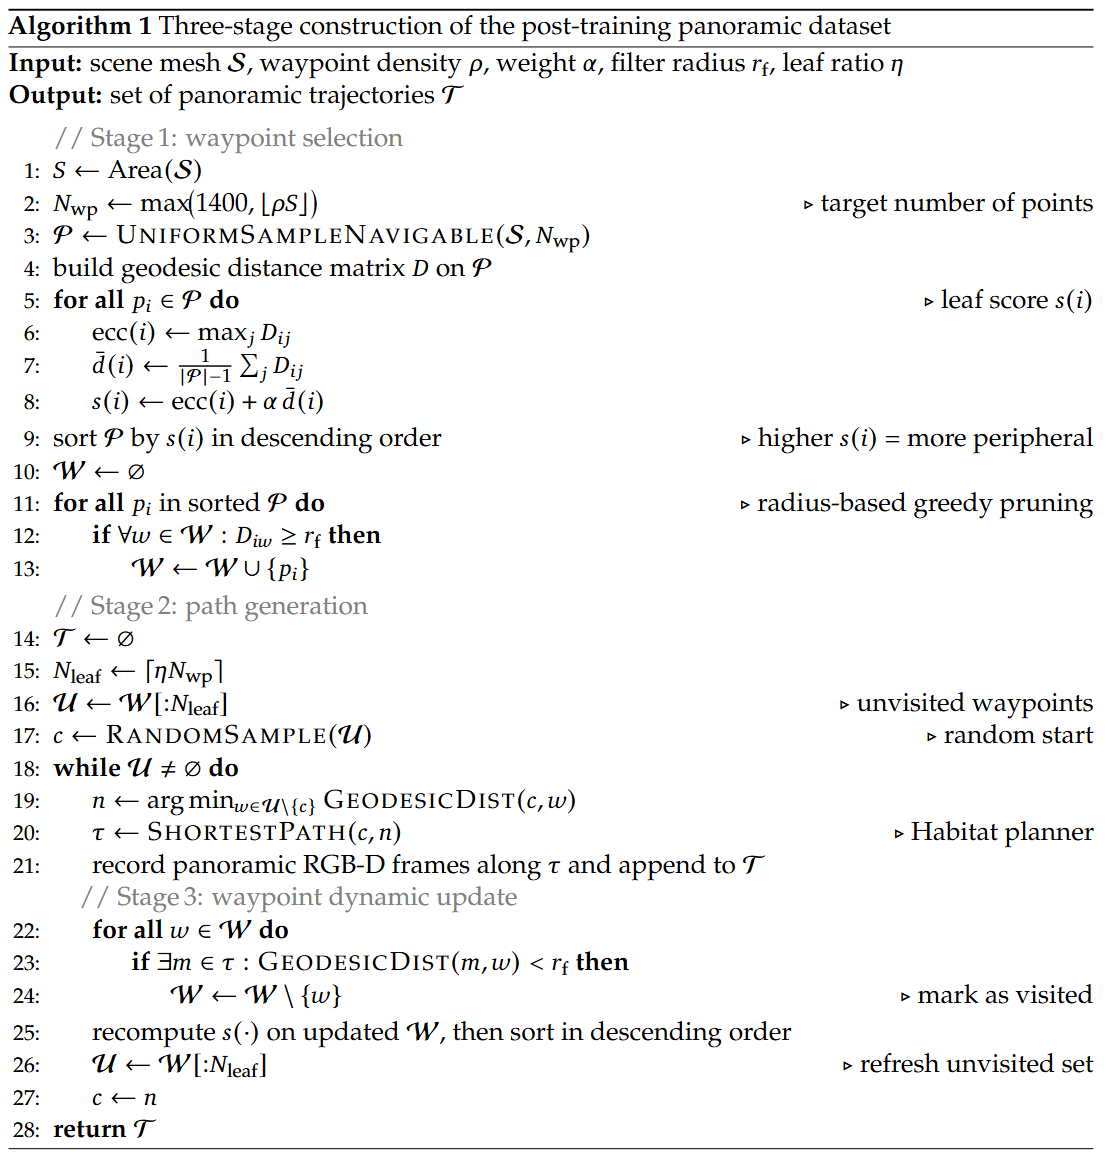
图 12 为场景俯视图可视化:红点和黄点是剪枝之后的最终路点。该策略把采样点大量分布在卧室等房间边缘,减少走廊内部冗余路径,得到视角丰富、空间分布均衡的训练轨迹。
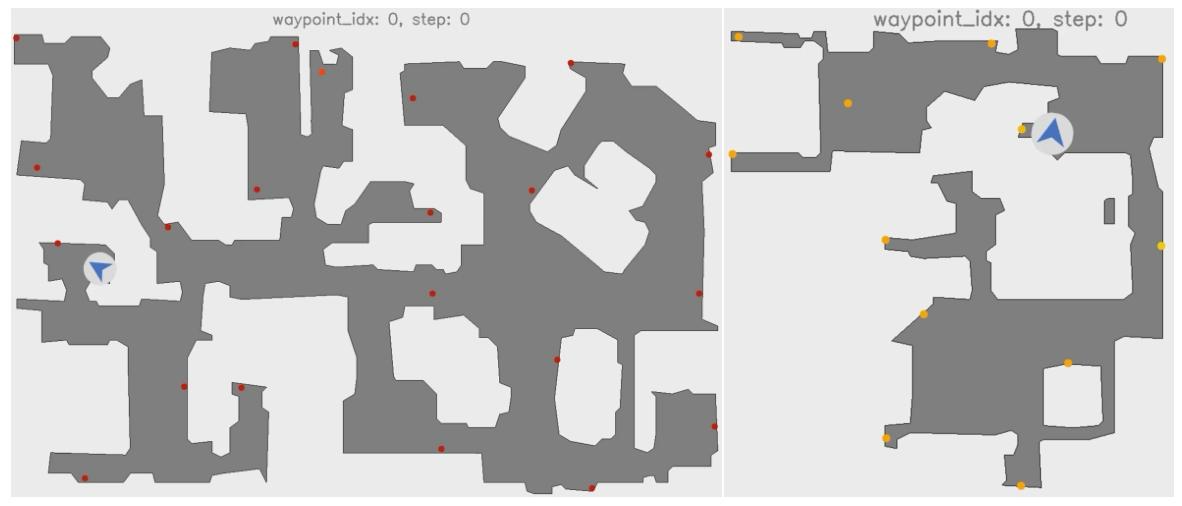 与简单随机起终点采样相比,本方法得到的数据集视角更均衡、多样,更适合视频模型后训练。
实验与实验结果
指标说明
实验指标可分为四类:任务主指标(衡量是否完成下游任务)、路径效率指标、世界模型特性/消融指标,以及 A-EQA 使用的辅助答案打分。
1. 任务主指标:SR(Success Rate,)
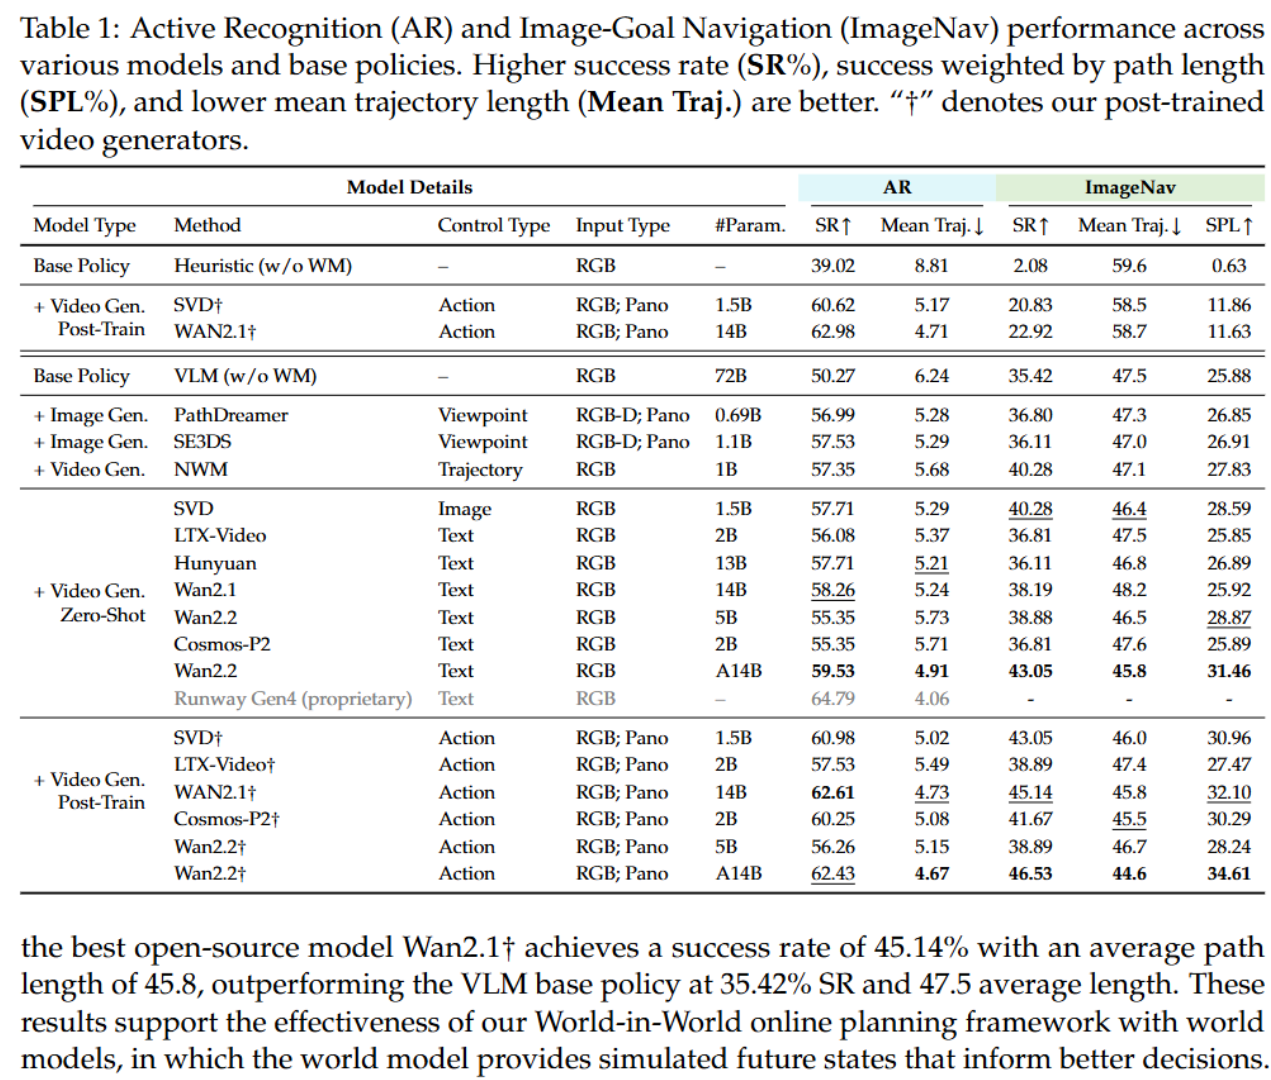
SR 是最核心的任务级指标:AR 中预测物体类别与 ground truth 一致即成功;ImageNav 中到达目标点 球形范围内即成功;Manipulation 中机械臂完成指定操作即成功。A-EQA 是开放式问答,不适合用二元成功/失败,因此以 Answering Score 为主。
2. 路径效率:Mean Trajectory Length()与 SPL()
其中 为第 个 episode 实际执行的动作/决策步数(导航为移动步数,操纵为机械臂决策步数)。在任务成功可比的前提下,该值越小表示规划更高效、绕路更少。
ImageNav 的 SPL(Success weighted by Path Length)同时要求“成功”且“走得短”:
为是否成功, 为模拟器真值给出的最短路径长度。失败 episode 得分为 0;成功但绕远路时 ,路径项会降低。因此,SR 高并不必然意味着 SPL 高。
AR 与 ImageNav 的主实验结果如下,表中可直接对照 SR、Mean Traj. 和 SPL:
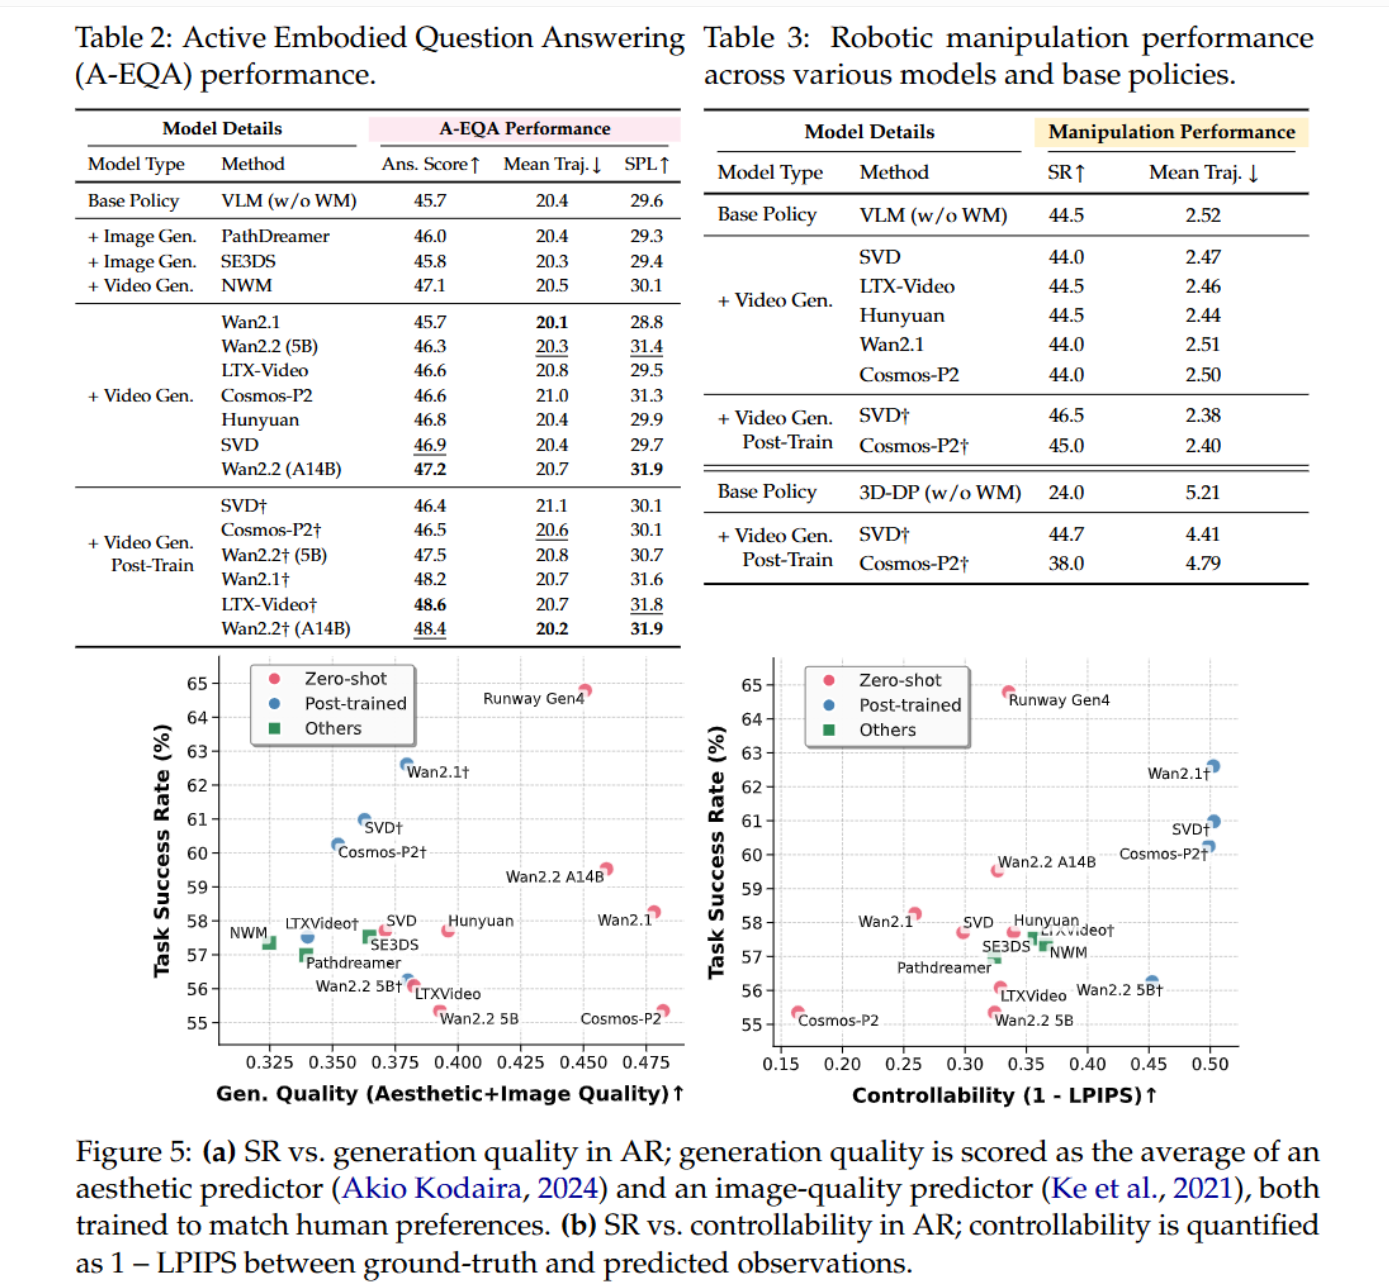
A-EQA 采用答案质量加权的定制 SPL:
这里 是到达可回答问题的观察点的最短路径, 是答案原始评分。该设计使“走到正确位置但答案错误”的轨迹同样被扣分。
3. A-EQA 辅助打分:Answering Score()
GPT-4o 将智能体答案与 ground truth 对比,给出 的分数;每个 episode 线性映射为
再对全部 episode 取平均。1 分对应 0 分(完全错误),5 分对应 100 分(完全匹配)。它评价答案语义正确性,而 A-EQA SPL 进一步把该质量与导航效率结合。
4. 世界模型特性与消融指标:Gen. Quality、Controllability
这些都是预训练好的神经网络打分器
Gen. Quality 评价的是世界模型生成帧本身,而不是任务是否完成。
Gen. Quality 将美学预测分数与无参考图像质量指标 MUSIQ 等权平均,
其中 是世界模型在给定动作下预测的观察帧, 是模拟器执行相同动作后的真实帧;LPIPS 是感知图像距离,越小表示两帧在感知特征上越接近。故 越高,说明模型越能准确响应动作、较少漂移或幻觉。
论文的关键结论是:Controllability 与任务 SR 呈更明显的正相关,而 Gen. Quality 与 SR 的关联较弱;对于具身世界模型,“动作可控”通常比“画面好看”更重要。
下图上半部分给出 A-EQA 与操纵任务结果;下半部分则直接比较 SR 与生成质量、可控性的关系:
下图对应后训练数据规模与推理时世界模型调用次数的消融结果:
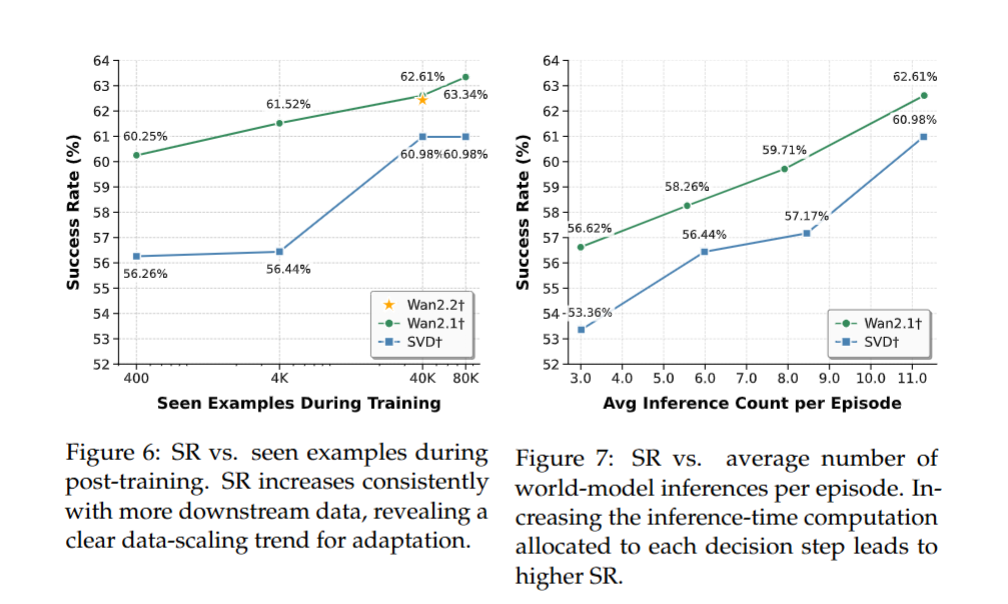
所以
- 视频质量和任务成功率不相干,可控性更重要
- 后训练有用,收益高于训练生成基模
- 推理时增加候选动作,即投入算力有用
Summary
个人感觉这篇文章奠基意义大些,并无很多很新的东西
其中没有学习动力学,文中世界模型大多都与视频生成模型无异,无感知抗外力能力,后训练任务只是让agent在特定场景下动作更加准确,但是主动动作外的外力无法建模