相机坐标相关
1. 相机如何描述一条视线
相机拍到的是二维像素,但机器人需要知道物体在三维空间中的位置。这个过程首先依赖相机内参矩阵 K:
K=fx000fy0cxcy1.
其中,fx,fy 是以像素为单位的焦距,cx,cy 是主点坐标。它们共同描述了“相机坐标系中的一条视线”如何对应到图像中的一个像素。
物理焦距只有一个,记为 f,单位通常为毫米。它是相机光心到成像平面的距离。若单个像素的物理宽、高分别为 sx,sy,则像素单位下的焦距为:
fx=sxf,fy=syf.
因此,fx 和 fy 通常很接近,但不必严格相同:像素在横、纵方向的物理尺寸可能不同,实际标定也会产生细微差异。现代相机的像素通常接近正方形,所以常见 fx≈fy。
主点 (cx,cy) 是相机光轴与图像平面的交点在像素坐标中的位置。理想情况下,它位于图像几何中心;但传感器安装、裁剪和标定误差都可能使其略有偏移。主点不在中心不会改变投影原理,只意味着计算视线方向时,必须以 (cx,cy) 而不是图像中心作为像素坐标原点。
例如,对于一张大小为 640×480 的图像,相机内参可以是:
K=60000060003202401.
这时主点位于 (cx,cy)=(320,240),即图像中心附近。
2. 从像素恢复相机坐标系中的三维点
2.1 相机坐标系与深度
以相机光心为原点,常用的相机坐标系约定为:Xc 向右,Yc 向下,Zc 沿光轴指向相机正前方。空间点写作:
Pcamera=XcYcZc.
这里的深度定义为:
z=Zc.
它表示该点沿相机光轴、也就是垂直于图像平面的距离,而不是相机光心到该点的直线距离。后者为:
r=Xc2+Yc2+Zc2.
例如,所有位于相机前方 1 m 的平面上的点都有 Zc=1 m,即使它们在画面左右两侧、与相机光心的直线距离不同。
2.2 从空间点到像素:针孔投影
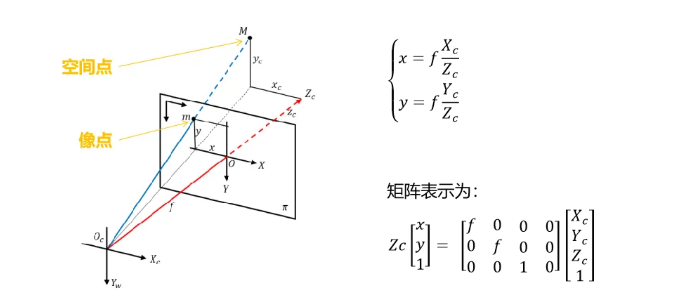
设空间点为 (Xc,Yc,Zc)。该点发出的光线穿过相机光心后落在成像平面上;由相似三角形,可得成像平面物理坐标 (x,y):
fx=ZcXc,fy=ZcYc.
也就是:
x=fZcXc,y=fZcYc.
这就是针孔相机的透视投影:在相同横向位置下,Zc 越大,点在图像上的偏移越小。将物理坐标换成以像素为单位的坐标,并以主点为偏移量后,得到:
u=fxZcXc+cx,v=fyZcYc+cy.
2.3 已知深度时的反投影
仅有像素 (u,v) 时,能确定的只是一条从相机光心出发的射线,不能确定唯一的三维点。若深度相机或其他方法给出了该像素的深度 z=Zc,便可以将上式反解,恢复其在相机坐标系中的三维坐标:
XcYcZc=fx(u−cx)z,=fy(v−cy)z,=z=depth.
变量含义如下:
| 符号 | 含义 | 常用单位 |
|---|
| Xc,Yc,Zc | 三维点在相机坐标系中的右、下、前坐标 | m |
| z | 深度,即 Zc,垂直于图像平面的距离 | m |
| r | 相机光心到三维点的直线距离 | m |
| u,v | 图像中的像素横、纵坐标 | pixel |
| x,y | 成像平面上的物理坐标 | mm |
| f | 物理焦距,即光心至成像平面的距离 | mm |
| fx,fy | 以像素表示的横、纵方向焦距 | pixel |
| cx,cy | 主点,即光轴落在图像上的像素坐标 | pixel |
例如,取:
(u,v)=(380,270),z=0.8 m.
使用上一节的相机内参,可得:
XcYcZc=600(380−320)×0.8=0.08 m,=600(270−240)×0.8=0.04 m,=0.8 m.
因此,这个像素对应的三维点为:
pcamera=0.080.040.80m.
这里的下标 camera 表示该坐标是在相机坐标系中表达的;该点的深度为 Zc=0.8 m,而它到相机光心的直线距离约为 0.805 m。
3. 用齐次矩阵表示位姿
机器人中常用 4×4 的齐次变换矩阵表示一个坐标系的位姿:
T=[R0t1]=r11r21r310r12r22r320r13r23r330txtytz1.
其中:
- R∈R3×3 是旋转矩阵,描述坐标系的朝向;
- t∈R3 是平移向量,描述坐标系原点的位置。
若连续进行两个坐标变换,齐次矩阵可以直接相乘:
[R10t11][R20t21]=[R1R20R1t2+t11].
这表示先执行右侧的变换,再执行左侧的变换。
4. 相机外参与抓取位姿
相机外参描述相机坐标系相对于世界坐标系的位置和朝向。记为:
E=Tworld←camera.
它将相机坐标系中的点或位姿转换到世界坐标系中。
抓取算法通常给出夹爪相对于相机坐标系的候选位姿:
Gcamera=Tcamera←gripper.
因此,坐标变换链为:
gripper⟶camera⟶world.
夹爪在世界坐标系中的最终位姿为:
Gworld=EGcamera=Tworld←cameraTcamera←gripper.
这样,视觉模型在相机坐标系中预测的抓取位姿,便可以转换为机器人执行所需的世界坐标系位姿。