WAN: OPEN AND ADVANCED LARGE-SCALE VIDEO GENERATIVE MODELS
重点学一下structure
data, scaling, efficiency 略过
Structure
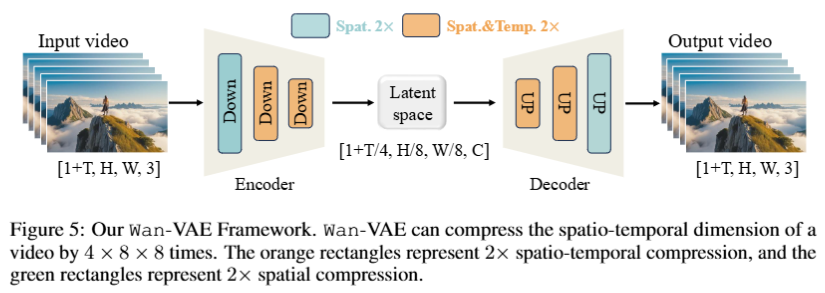
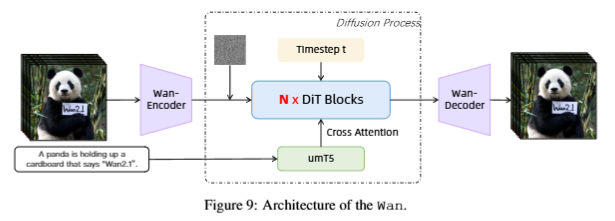
首帧图片处理
输入 1 + 4n 帧,首帧不需要时间降采样 最后经过 VAE 得到 1 + n 个 latent
噪声 latent 的形状对应整段待预测视频。一张图片本身只有一个时间位置,所以 第一帧放图片 后面全部补0,再经过 Wan-VAE Encoder
Wan-I2V 还有另一条图像路径:
这条路径不需要变成噪声的形状,因为它通过 Cross-Attention 注入:
Streamer 流式生成
预训练的 Wan 模型用于生成固定时长的视频片段,时长通常为 5‑10 秒。若要将其改造为实时流式模型,使其能够生成无预设长度(理论上可无限长)的连续视频流,需要进行两处关键修改:
- Streaming pipeline adaptation:一套流式机制,增量式生成视频 token。在该流式框架中,视频 token 经由一个去噪队列进行处理:每当最旧的 token 完成生成并出队,就会在队列尾部新增一个 token,由此实现不受长度限制的连续生成
- Real-time acceleration:生成速度做了优化,该流水线生成新帧的速度必须足以跟上实时播放的速率